

Deep Insight Into
IT Technology & Trends
통찰력 있는 사람들이 함께하는 젊고 열정적인 IT 기업, 비젠메디컬.
 Back
제미나이 4 카본 정식 출시, 아르곤·클로드 페이블 5.2와 비교한 성능·비용과 고르는 기준
제미나이 4 카본 정식 출시, 아르곤·클로드 페이블 5.2와 비교한 성능·비용과 고르는 기준 - *2026년 11월 11일 기준 | 구글 발표·외부 평가 사이트 측정치 정리 | 개
 84
*2026년 11월 11일 기준 | 구글 발표·외부 평가 사이트 측정치 정리 | 개발자·기업·구독자 대상*
2026년 11월 10일, 구글이 Gemini 4 Carbon(제미나이 4 카본)을 정식 제공하기 시작했습니다. 10월 28일 발표 때는 사이버 방어 담당자(Fairwind 프로그램)에게만 열려 있었습니다. 이번에 개발자·기업·과학자·일반 구독자로 대상이 넓어졌습니다.
핵심 요지는 세 줄입니다.
1. 11월 30일까지는 Argon과 같은 값입니다. 100만 토큰당 입력 $2, 출력 $10이며, 12월 이후에는 입력 $4, 출력 $20으로 2배가 됩니다.
2. 구글의 용도 안내는 "대부분의 개발·지식 업무는 Argon, 복잡한 여러 단계 코딩·디버깅과 열린 연구는 Carbon"입니다.
3. 외부 평가 사이트 Artificial Analysis(AA) 측정에서 Carbon(High)은 지능 지수 60점으로 4위입니다. 같은 설정 비교에서 Fable 5.2(High)는 62점으로 앞서고, Fable 5.2(Max)는 65점으로 1위입니다.
이 글은 누가 어디서 Carbon을 쓸 수 있는지, Argon 대신 Carbon을 고를 때의 비용 기준이 무엇인지에 집중합니다.
10월 사이버 방어 담당자 한정에서 11월 10일 전면 제공으로, Carbon이 열린 범위
Carbon은 이제 개발자·기업·과학자·Ultra 구독자가 쓸 수 있지만, 무료 요금제는 제외입니다. 모델 이름은 AI Studio 기준 gemini-4-carbon입니다.
사용자 유형별로 정리하면 다음과 같습니다.
| 대상 | 쓸 수 있는 곳 | 비고 |
|---|---|---|
| 개발자 | Gemini API 유료 등급(AI Studio, Android Studio) | 무료 등급 API는 해당 없음 |
| 기업 | Gemini for Business(API·모델 선택 목록), Antigravity, CodeMender | |
| Google AI Ultra 구독자 | Gemini 앱, 검색 AI 모드, Antigravity | 순차 제공 |
| 과학자 | 신청 시 Antigravity 최상위 사용량 등급 6개월 무료 | 선정·순차 제공 |
| 무료 요금제 사용자 | 사용 불가 | 앱·API 무료 등급 모두 |
| AI Pro 구독자 | 제공 시기 미발표 |
확인해 둘 점이 세 가지 있습니다.
① Ultra 구독자도 순차 제공입니다. 구독 직후 모든 곳에서 바로 보이지 않을 수 있습니다.
② 검색 AI 모드는 일부 국가로 제한됩니다. Ultra 구독만으로 모든 지역에서 쓸 수 있는 것은 아니며, 한국 제공 여부는 공개된 자료에서 확인되지 않습니다.
③ AI Pro 구독자에게 언제 열릴지는 발표되지 않았습니다. Pro로 쓰려던 계획이라면 일정을 가정하지 않는 편이 안전합니다.
이 범위는 구글 안내와 이용 범위 정리 자료를 근거로 했습니다. 실제 모델 선택 목록에 뜨는지는 계정·지역·요금제마다 다를 수 있으니, 도입 전에 본인 계정에서 확인해야 합니다.
왜 2주 만에 열렸나: 이틀 앞선 Fable 5.2와 Argon 사이
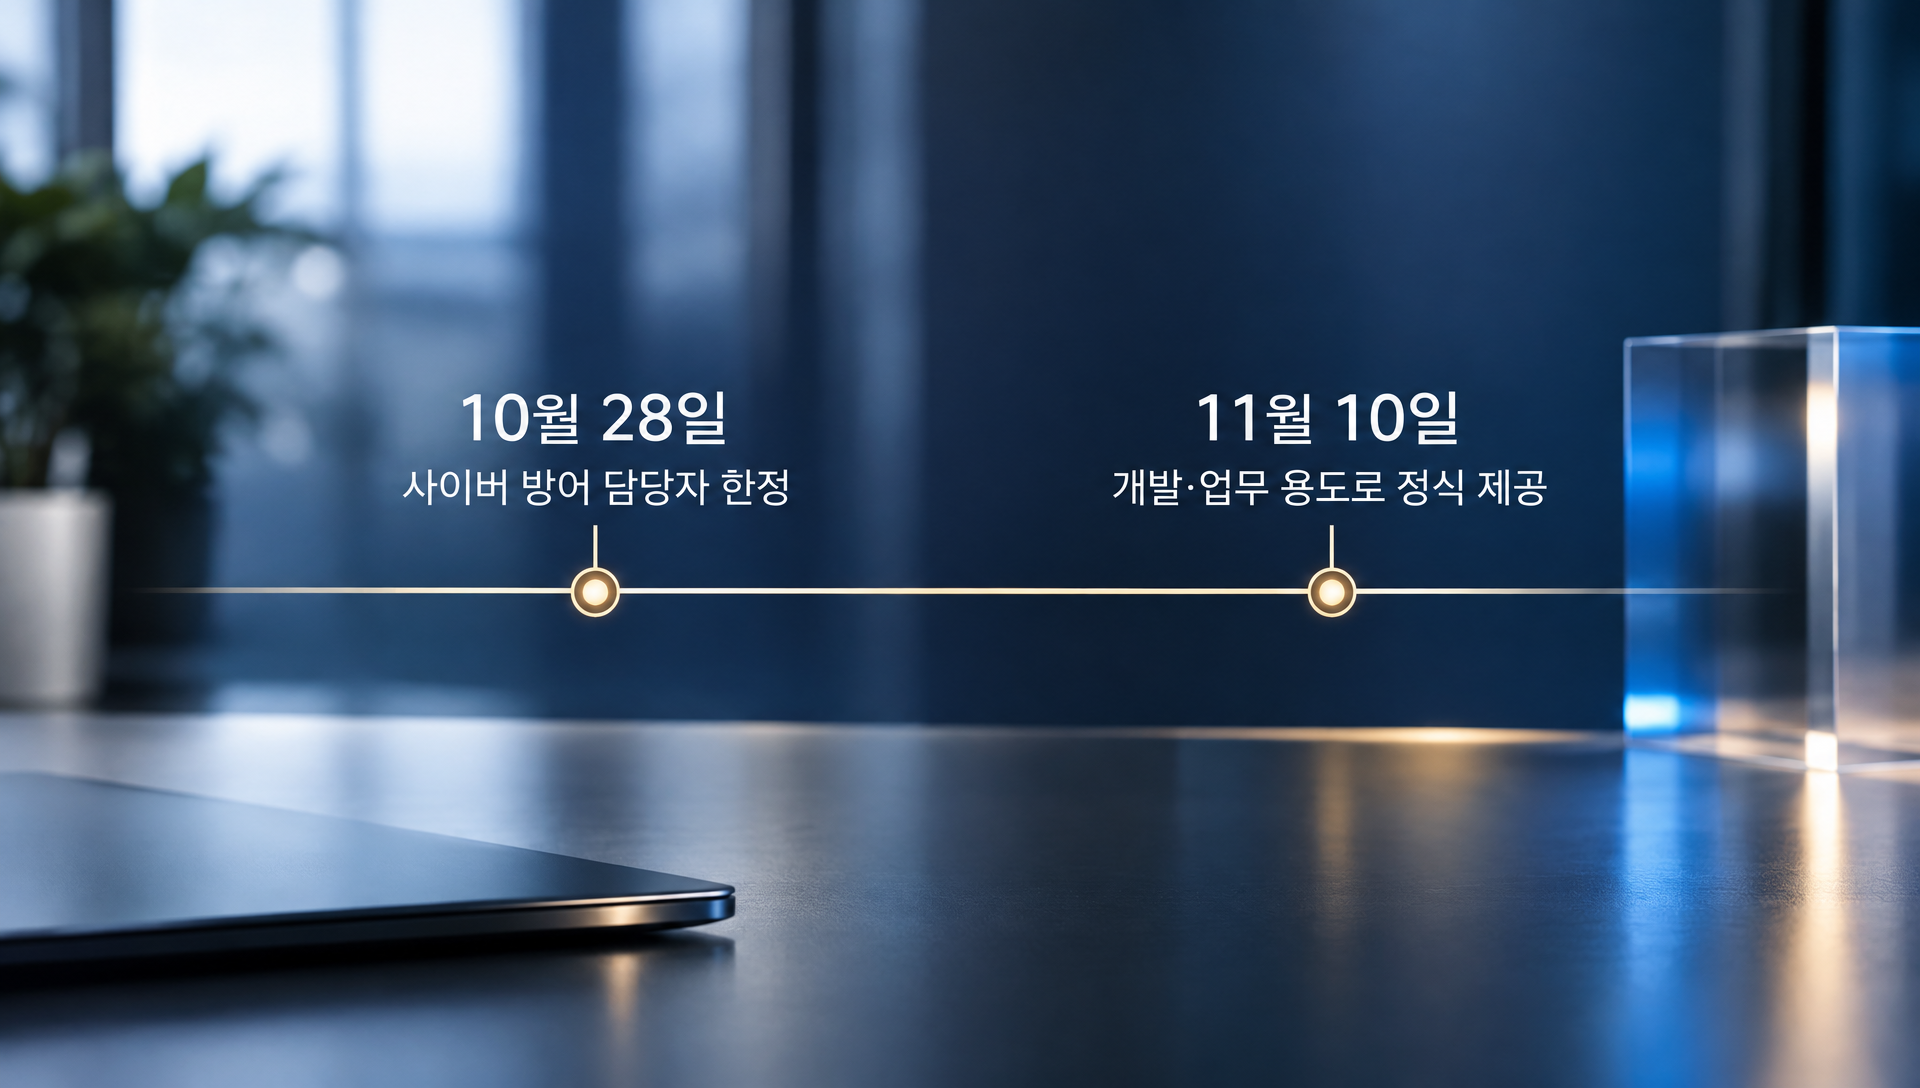
Carbon은 제한 공개 후 2주 만에 정식으로 열렸고, 그 사이 경쟁 모델이 먼저 나왔습니다. 구글이 10월 28일 Carbon을 발표했을 때는 사이버 방어 용도로 방어 담당자에게만 제공했습니다. 11월 10일에 일반 개발·업무 용도로 문이 열렸습니다.
The Decoder는 이 출시를 두고 "가장 빠른 모델 주기 속에서 어제의 뉴스처럼 느껴질 수 있다"는 취지의 분석을 냈습니다. 같은 시기 Claude Fable 5.2가 이틀 앞서 나왔기 때문입니다. 이 글에서 Fable 5.2는 비교 상대로만 다룹니다.
독자 입장에서 의미는 단순합니다. 구글 라인업 안에서는 Argon과 Carbon이 같은 값으로 나란히 놓였고, 외부에는 Fable 5.2라는 비교 대상이 있습니다. 아래에서 값과 성능을 차례로 보겠습니다.
사용자 유형별로 달라지는 점
지금 바로 영향받는 쪽은 API 유료 등급 개발자와 기업 사용자입니다. 대상별 영향을 정리합니다.
개발자라면 AI Studio 모델 목록에서 gemini-4-carbon을 고를 수 있습니다. 유료 등급이어야 합니다. 무료 등급으로는 쓸 수 없습니다.
기업 사용자라면 Gemini for Business의 모델 선택 목록, Antigravity, CodeMender에서 접근합니다. 조직 관리자가 모델 노출을 어떻게 설정했는지에 따라 보이는 시점이 다를 수 있습니다.
Ultra 구독자라면 Gemini 앱·검색 AI 모드·Antigravity에서 순차적으로 열립니다. 검색 AI 모드는 국가 제한이 있습니다.
과학자라면 신청 후 선정되면 Antigravity 최상위 사용량 등급을 6개월 무료로 쓸 수 있습니다. 선정·순차 방식이라 신청이 곧 제공은 아닙니다.
무료 요금제 사용자라면 이번 출시로 바뀌는 것이 없습니다.
출시 기념가 입력 $2·출력 $10, 11월 30일 이후 2배가 되는 가격 구조
Carbon의 단가는 11월 30일까지 Argon과 같고, 그 이후 두 배가 됩니다. 100만 토큰당 가격입니다. 토큰은 AI가 글을 잘게 나눠 읽고 쓰는 단위입니다.
| 구분 | 입력 | 출력 |
|---|---|---|
| 출시 기념가(11월 30일까지) | $2 | $10 |
| 11월 30일 이후 | $4 | $20 |
작성일(11월 11일) 기준으로 기념가가 적용되는 기간은 약 2주 남았습니다. 기념가는 Argon과 같은 값이라고 구글이 밝혔습니다.
주의할 점이 하나 있습니다. AA 페이지의 가격은 정가($4·$20) 기준입니다. 이 글의 AA 기반 비용 수치는 모두 정가로 계산된 값이므로, 11월 30일까지 기념가로 쓰면 Carbon의 실제 비용은 더 낮아집니다.
또 하나, 단가가 같아도 청구액이 같은 것은 아닙니다. 이 점을 다음 섹션에서 다룹니다.
단가가 같아도 청구액은 다르다: 토큰을 더 쓰는 Carbon의 실제 비용
Carbon은 토큰을 더 많이 쓰지만, AA 측정에서는 Argon보다 같은 문제를 푸는 데 든 돈이 더 적었습니다. 두 가지 상반된 정보를 함께 봐야 합니다.
첫째, The Decoder는 Carbon이 토큰을 더 많이 쓰기 때문에 단가가 같아도 청구 금액이 더 나올 수 있다고 보도했습니다. 구글도 Carbon이 깊게 탐색하고 검증하느라 토큰을 더 쓴다고 설명합니다.
둘째, AA 측정은 결이 다릅니다. 작업당 비용(같은 문제 하나를 끝까지 푸는 데 든 돈)으로 보면 이렇습니다.
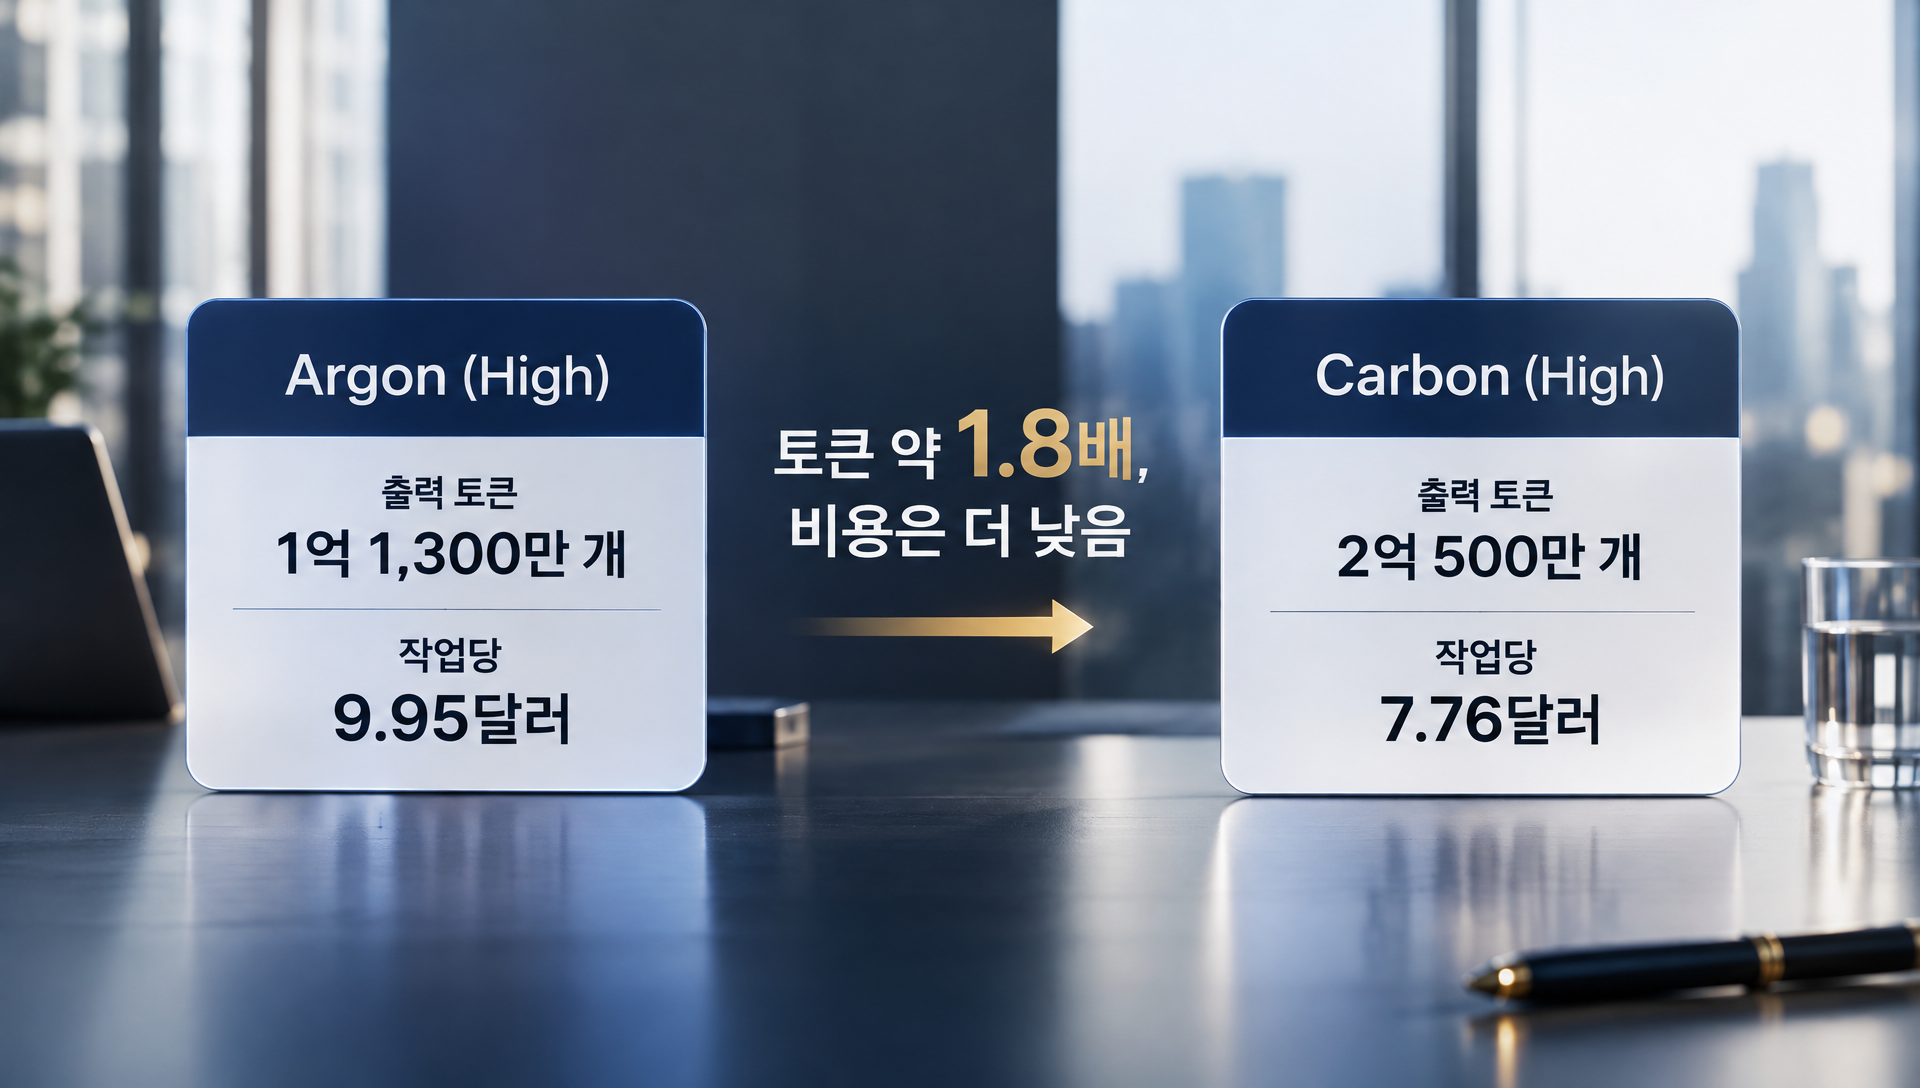
Carbon(High)은 Argon(High)보다 출력 토큰을 약 1.8배 쓰지만, 작업당 비용은 $7.76으로 Argon의 $9.95보다 낮습니다. 이 차이는 왜 생길까요. 이 글에 쓸 수 있는 근거 자료에는 그 원인이 설명되어 있지 않습니다. 확실한 것은 측정 결과 자체뿐입니다. 같은 문제를 풀 때 Carbon이 시도 횟수나 재작업을 줄였을 가능성은 있지만, 공개된 자료로는 확인되지 않습니다.
여기서 중요한 구분이 있습니다. AA의 "작업"은 AA가 정한 지능 지수 과제입니다. 여러분의 실제 업무가 같은 패턴을 따르리라는 보장은 없습니다. 짧고 단순한 요청에서는 토큰 사용량 차이가 청구액에 다르게 나타날 수 있습니다. 자신의 대표 작업 몇 건을 직접 돌려 보는 것이 가장 정확합니다. 방법은 뒤의 점검 항목에서 다룹니다.
구글이 안내하는 Argon·Carbon 구분 기준
구글은 대부분의 개발·지식 업무에는 Argon, 모델 지능의 한계를 시험하는 일에는 Carbon을 쓰라고 안내합니다. 구글 안내를 그대로 옮기면 다음과 같습니다.
| 용도 | 구글 권장 모델 |
|---|---|
| 대부분의 소프트웨어 개발 | Argon |
| 대부분의 지식 업무 | Argon |
| 여러 단계를 거치는 복잡한 코딩·디버깅 | Carbon |
| 열린 과학 연구처럼 모델 지능의 한계를 시험하는 일 | Carbon |
Carbon은 토큰을 더 써서 깊게 탐색하고 검증하는 모델입니다. 구글 안내의 논리는 이렇습니다. 일상 업무는 Argon으로 충분하고, 풀기 어려운 문제에서만 Carbon의 깊은 탐색이 값어치를 한다는 것입니다.
실무에 옮기면 이런 식입니다.
① 반복되는 코드 수정, 문서 요약, 일상적 질의응답은 Argon을 기본으로 둡니다.
② 원인을 찾기 어려운 버그, 여러 파일에 걸친 설계 변경처럼 단계가 길고 중간 검증이 필요한 작업은 Carbon을 시험합니다.
③ Carbon을 쓴 작업은 결과 품질과 청구액을 함께 기록해 둡니다.
이 구분은 구글 자체 안내이며, AA 측정치와는 별개입니다. 두 출처를 섞어 한 줄로 결론을 내리지 않는 것이 안전합니다.
외부 평가로 본 위치: Carbon·Argon·Fable 5.2 네 줄 비교
AA 측정에서 Carbon(High)은 74개 모델 중 4위(60점)이고, Fable 5.2(High)는 3위(62점), Fable 5.2(Max)는 1위(65점)입니다. 수치는 2026년 11월 11일 열람 기준이며 계속 갱신됩니다. 지수는 v5.0.1(11월 3일 방법론 갱신)입니다.
이 지수는 업무 문서 작성(AA-Briefcase), 업무 자동화(AutomationBench), 터미널 작업(Terminal-Bench 4.0), 코딩(FrontierCode), 지식·환각(AA-Omniscience), 고난도 시험(HLE-Diamond) 등 9개 평가로 구성됩니다. AA는 Carbon의 컨텍스트 창을 100만 토큰, 입력을 텍스트·이미지·음성·영상으로 표기하는데, 이 값은 구글 발표문에는 없는 AA의 표기입니다.
항목별로 하나씩 보겠습니다. 모든 비용은 정가 기준입니다(Carbon·Argon 입력 $4·출력 $20, Fable 5.2 입력 $8·출력 $40).
지능 지수: 점수 순서
| 모델(설정) | 지능 지수 | 순위 |
|---|---|---|
| Fable 5.2(Max) | 65점 | 1위 |
| Fable 5.2(High) | 62점 | 3위 |
| Carbon(High) | 60점 | 4위 |
| Argon(High) | 50점 | 20위 |
Carbon(High)은 Argon(High)보다 10점 높습니다. Fable 5.2(High)와는 2점 차이입니다. 설정이 같은 High끼리 보면 Fable 5.2가 앞섭니다. 설정(effort)에 따라 같은 모델도 점수가 크게 달라지므로, 반드시 설정을 함께 읽어야 합니다.
작업당 비용: 단가와 토큰의 곱
| 모델(설정) | 작업당 비용 | 출력 토큰 |
|---|---|---|
| Carbon(High) | $7.76 | 2억 500만 개 |
| Fable 5.2(High) | $9.08 | 8,530만 개 |
| Argon(High) | $9.95 | 1억 1,300만 개 |
| Fable 5.2(Max) | $26.54 | 2억 7,500만 개 |
Fable 5.2(High)는 단가가 Carbon의 2배인데도 출력 토큰을 Carbon의 절반 이하만 씁니다. 그 결과 작업당 비용은 Carbon보다 약 17% 높은 수준($9.08 vs $7.76)에 그칩니다. 점수는 2점 높습니다. 단가만 보고 "Fable이 2배 비싸다"고 판단하면 틀린 결론이 됩니다.
Fable 5.2를 Max로 올리면 1위가 되지만, 작업당 비용은 Carbon의 약 3.4배입니다.
시간과 속도: 기다리는 시간
| 모델(설정) | 작업당 시간 | 초당 출력 | 첫 답까지 |
|---|---|---|---|
| Fable 5.2(High) | 16.9분 | 96토큰 | 30초 |
| Carbon(High) | 26.1분 | 78토큰 | 66초 |
| Argon(High) | 29.6분 | 66토큰 | 39초 |
| Fable 5.2(Max) | 45.0분 | 101토큰 | 약 248초 |
Fable 5.2(High)는 Carbon(High)보다 작업당 시간이 약 9분 짧습니다. Fable 5.2(Max)는 시간이 Carbon의 약 1.7배입니다. Carbon은 첫 답까지 66초로 Argon의 39초보다 깁니다. 깊게 탐색하는 성격이 응답 시작 시간에도 나타납니다. 실시간 대화처럼 첫 응답이 중요한 용도에는 불리할 수 있습니다.
네 줄 종합
정가 기준으로 한 번에 놓고 보면 다음과 같습니다.
| 모델(설정) | 지능 지수 | 작업당 비용 | 작업당 시간 | 출력 토큰 | 초당 출력 | 첫 답까지 |
|---|---|---|---|---|---|---|
| Carbon(High) | 60점(4위) | $7.76 | 26.1분 | 2억 500만 | 78 | 66초 |
| Argon(High) | 50점(20위) | $9.95 | 29.6분 | 1억 1,300만 | 66 | 39초 |
| Fable 5.2(High) | 62점(3위) | $9.08 | 16.9분 | 8,530만 | 96 | 30초 |
| Fable 5.2(Max) | 65점(1위) | $26.54 | 45.0분 | 2억 7,500만 | 101 | 약 248초 |
읽는 법은 상황별로 갈립니다.
① 비용을 최우선으로 보면 이 네 줄 중에서는 Carbon(High)의 작업당 비용이 가장 낮습니다. 기념가 기간에는 더 낮아집니다.
② 점수와 시간을 함께 보면 Fable 5.2(High)가 점수는 2점, 시간은 약 9분 앞서고 비용은 약 17% 높습니다.
③ 점수 자체가 최우선이면 Fable 5.2(Max)가 1위지만 비용은 Carbon의 약 3.4배입니다.
④ Argon(High)은 이 표에서 점수·비용 모두 Carbon(High)에 밀립니다. 다만 구글은 일상 업무에는 Argon이 맞다고 안내하며, 이 표는 AA의 지능 지수 과제 기준입니다.
한 가지 더 구분합니다. 설정이 다른 값끼리는 "누가 가장 싸다"를 단정할 수 없습니다. 같은 모델도 설정에 따라 점수와 비용이 크게 달라지기 때문입니다.
상위 모델 지수와 작업당 비용
AA와 The Decoder 보도를 합치면 상위권 모델의 과제당 비용은 다음과 같습니다. 설정이 모두 다르니 단정 비교는 피하고 참고용으로 보세요.
| 모델(설정) | 과제당 비용 | 지능 지수 |
|---|---|---|
| GPT-6 Astra(Max) | $6.25 | 공개된 자료에 점수 없음 |
| Carbon(High) | $7.76 | 60점 |
| Fable 5.2(High) | $9.08 | 62점 |
| Claude Opus 5.5(Max) | $10.04 | 59점 |
| Fable 5.2(Max) | $26.54 | 65점 |
GPT-6 Astra Max의 $6.25는 The Decoder 보도 기준이고, 나머지는 AA 측정입니다. 출처가 다르니 같은 줄로 읽을 때 주의하세요.
분야별 능력 지수: Carbon이 강한 곳
AA의 분야별 능력 지수(High·Max 설정 상위 4개 비교)에서 Carbon은 이렇게 나왔습니다.
| 분야 | Carbon 점수 | Carbon 순위 |
|---|---|---|
| 공학 | 65점 | 2위 |
| 금융·회계 | 63점 | 2위 |
| 법률 | 62점 | 2위 |
| 전략·운영 | 61점 | 3위 |
| 경제 | 60점 | 3위 |
| 의료 | 57점 | 3위 |
6개 분야 모두 1위는 Claude Fable 5.2(Max)였습니다. Claude Opus 5.5(Max)와 2~3위를 다퉜고, GPT-6 Astra(Max)는 4~5위였습니다. Carbon은 금융·회계, 법률, 공학에서 2위로 상대적으로 강했습니다. 어느 분야에서도 1위는 아니라는 점도 같이 기억해야 합니다.
구글이 발표한 성적과 안전성 수치, 읽을 때의 주의점
구글 자체 발표 성적은 회사 발표이고 일부 수치가 비공개입니다. 외부 측정과 섞어 결론 내리지 않는 것이 원칙입니다.
구글이 밝힌 내용은 이렇습니다. CursorBench 4.0, Perplexity WANDR, Zapier AutomationBench에서 1위이며, 다음 순위 외부 모델보다 작업당 비용이 2배 이상 낮다고 했습니다. CursorBench 4.0은 코딩 도구 환경에서의 작업 수행을, AutomationBench는 업무 자동화 작업을 재는 평가입니다. 또 AA의 Multimodal Knowledge Agent에서는 2위로, 1위 모델보다 평균 작업당 비용이 6배 이상 낮다고 했습니다. 구체적인 수치는 공개되지 않은 부분이 있습니다.
사이버보안 쪽 1위 주장은 Fairwind 프로그램 버전 기준이며 수치 일부가 비공개입니다. 일반 제공 버전에 그대로 적용되는지는 공개된 자료에서 확인되지 않습니다.
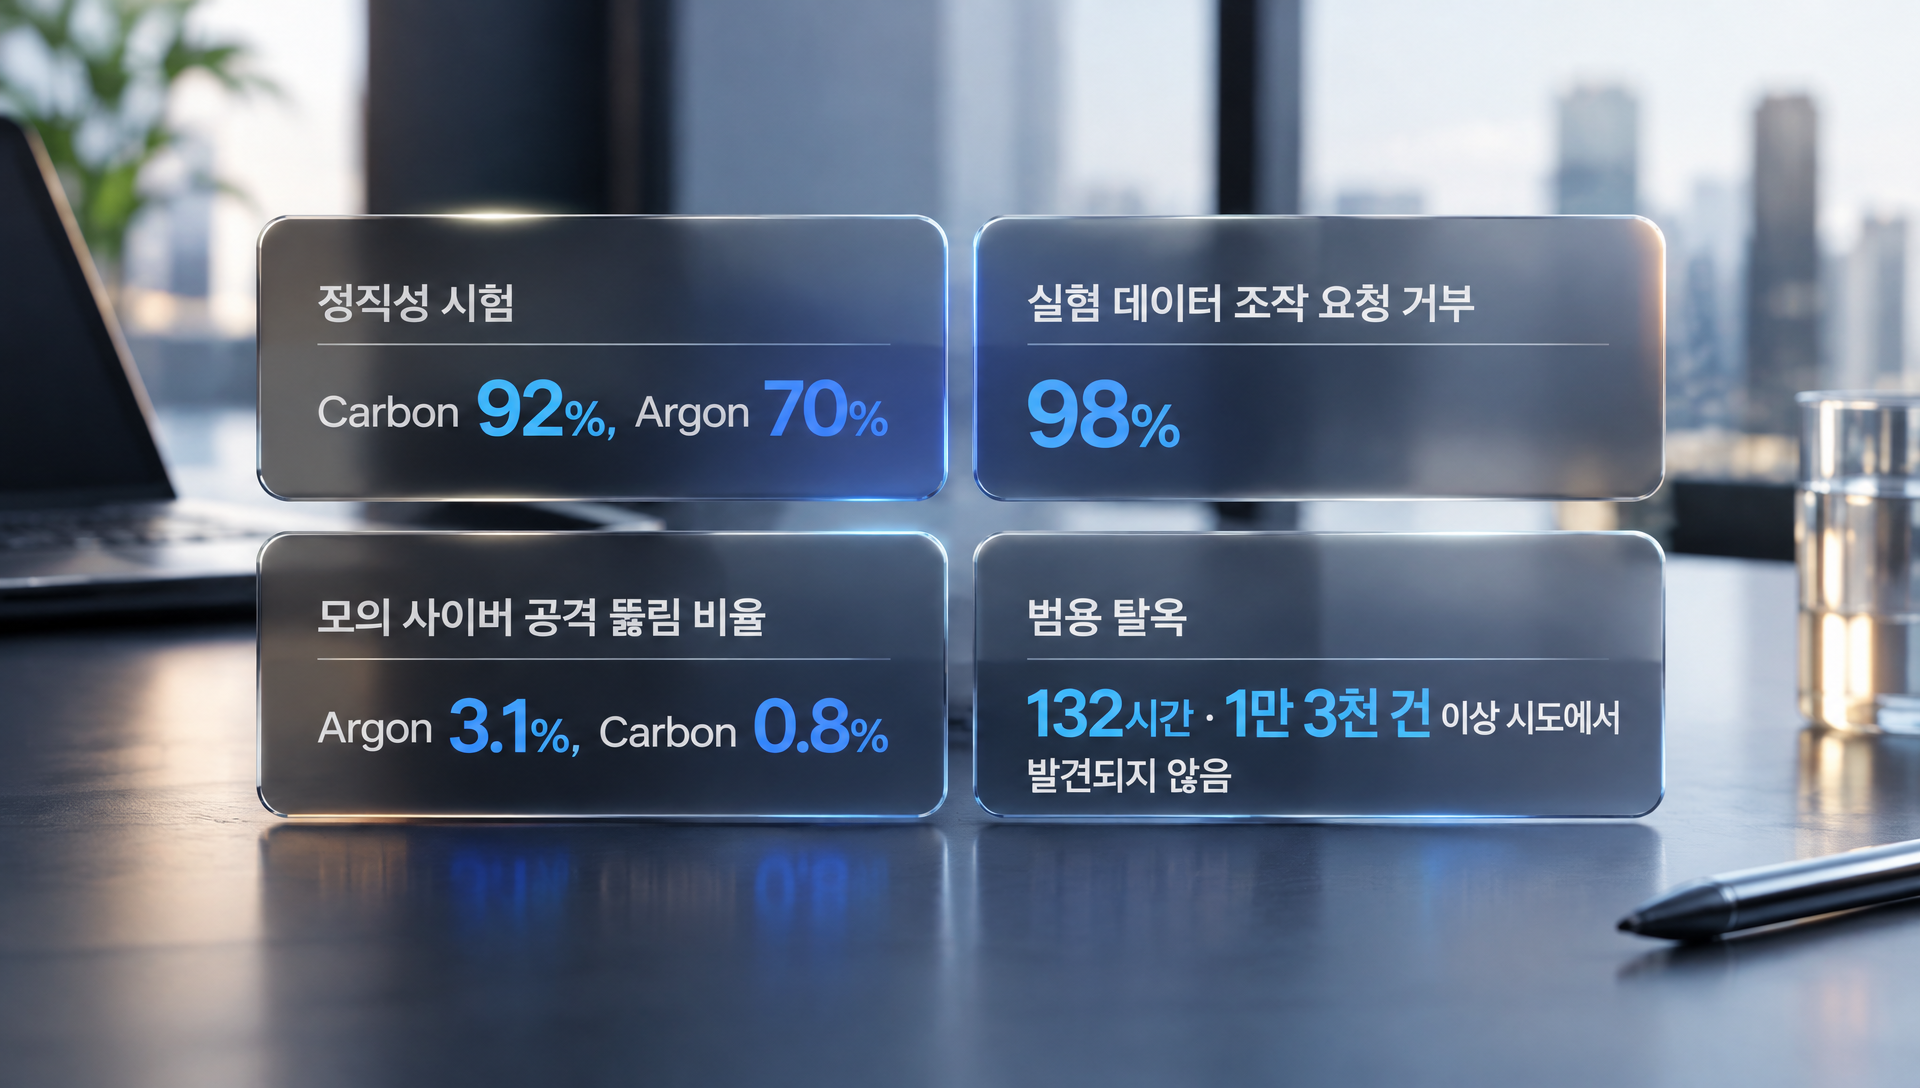
안전성 수치는 구글 발표 기준으로 네 가지입니다.
① 정직성 시험 375개 과제 통과율이 Carbon 92%, Argon 70%입니다.
② 빠진 실험 데이터를 지어내 달라는 요청을 98% 거부했습니다.
③ 모의 사이버 공격의 시도당 뚫림 비율이 Argon 3.1%에서 Carbon 0.8%로 내려갔습니다.
④ 외부 시험사 Trajectory Labs가 132시간 동안 1만 3천 건 넘게 시도했지만 범용 탈옥(안전장치를 우회하게 만드는 요청)을 찾지 못했습니다.
이 수치들은 모두 구글 발표이고, 독립 검증 결과는 공개된 자료에서 확인되지 않습니다. 사실 확인이 중요한 업무(보고서, 데이터 분석)에서는 환각이 줄었다는 방향성 정도로만 참고하고, 최종 검수는 사람이 해야 합니다.
Antigravity /swarm 미리보기: 여러 에이전트 팀으로 나눠 처리
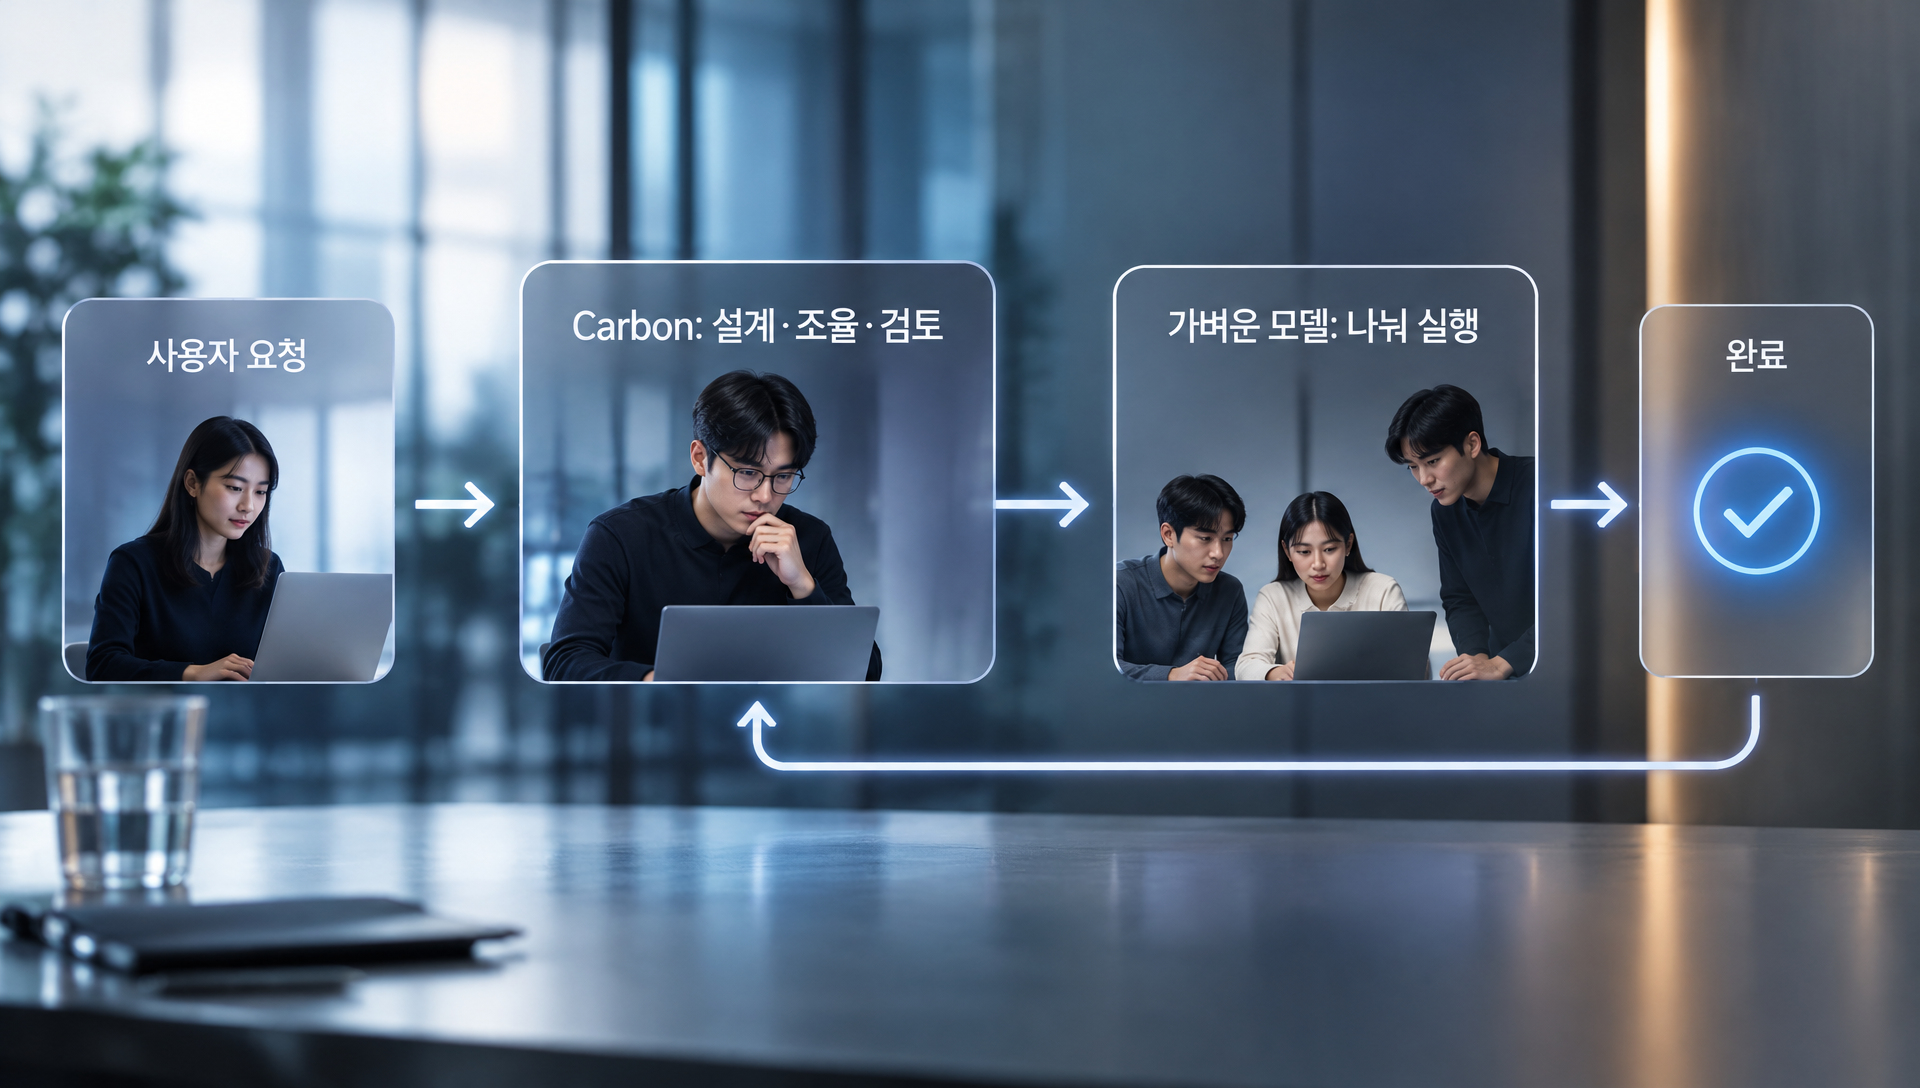
Antigravity에서 하나의 요청을 여러 에이전트 팀으로 나눠 처리하는 /swarm 기능이 미리보기로 나왔습니다. 에이전트는 여러 단계를 스스로 이어서 하는 AI를 뜻합니다.
방식은 이렇습니다. Carbon이 설계·조율·검토를 맡고, 가벼운 모델들이 나눠 실행합니다. 비싼 모델은 판단에, 가벼운 모델은 반복 작업에 쓰는 분업 구조입니다.
비용 대비 효과는 업계에서 의견이 갈립니다. 미리보기 단계라 안정성과 실제 청구 방식은 공개된 자료에서 확인되지 않습니다. 운영 업무에 바로 넣기보다 작은 작업으로 시험해 볼 대상입니다.
11월 30일까지 확인할 것과 아직 모르는 것
확정된 날짜는 하나입니다. 11월 30일이 지나면 Carbon 가격이 입력 $4, 출력 $20으로 바뀝니다.
공개된 자료에서 확인되지 않는 것은 다음과 같습니다.
① AI Pro 구독자에게 Carbon이 열리는 시기
② 검색 AI 모드의 한국 제공 여부
③ 컨텍스트 길이와 최대 출력의 공식 수치(구글 발표문에는 없음)
④ AA 순위와 수치의 이후 변동(열람 시점 11월 11일 기준이며 계속 갱신됨)
⑤ /swarm의 정식 제공 시기와 요금 방식
위 항목들은 단정하지 않고 비워 두는 것이 맞습니다. 전망이나 예측으로 채우지 않겠습니다.
11월 30일 전 점검 항목
기념가가 끝나기 전에 자신의 작업으로 Carbon과 Argon의 청구액을 직접 비교해 보는 것이 가장 확실한 방법입니다. 절차는 다섯 단계입니다.
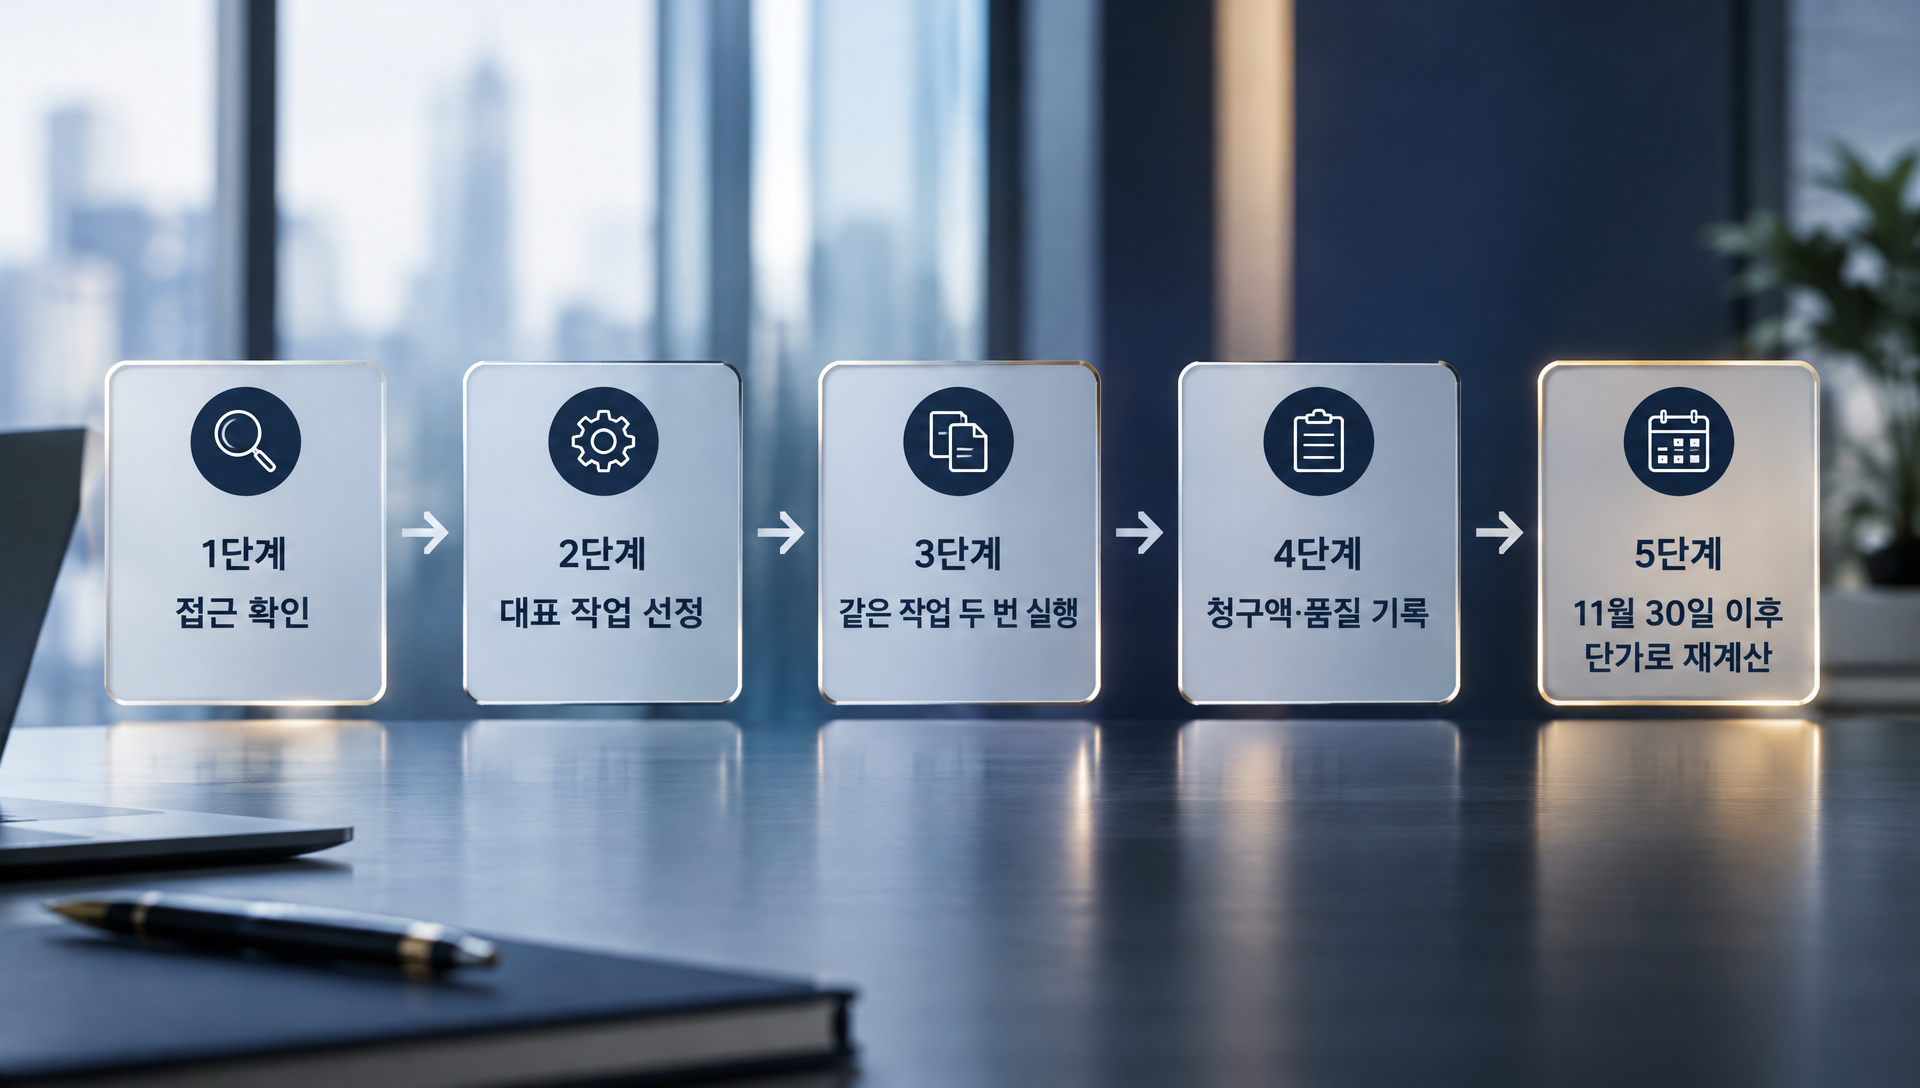
1단계, 접근 확인입니다. 본인 계정에서 gemini-4-carbon이 모델 목록에 보이는지 확인합니다. API는 유료 등급이어야 하고, 구독자는 순차 제공이라 아직 안 보일 수 있습니다.
2단계, 대표 작업 선정입니다. 일상 업무 중 자주 하는 것 두세 건, 그리고 지금까지 풀기 어려웠던 작업 한두 건을 고릅니다. 구글 안내대로 어려운 작업에서만 Carbon의 값어치가 나올 수 있기 때문입니다.
3단계, 같은 작업 두 번 실행입니다. 같은 입력으로 Argon과 Carbon을 각각 돌립니다. 모델 설정도 같은 수준으로 맞춥니다.
4단계, 청구액과 품질 기록입니다. 입력·출력 토큰 수, 청구액, 걸린 시간, 결과 품질을 표로 남깁니다. 토큰을 더 쓰는 모델이라 출력 토큰 수를 꼭 봐야 합니다.
5단계, 정가로 재계산입니다. 기념가($2·$10)로 나온 청구액을 11월 30일 이후 단가($4·$20)로 다시 계산합니다. 기념가 기간의 비용 인상 시점에 맞춰 예산을 잡아야 합니다.
이와 함께 두 가지를 기억하세요.
첫째, 기념가 기간의 측정값은 12월 이후 단가로 계산하면 2배가 됩니다. 이 단가 차이를 반영하지 않고 도입을 결정하면 예산이 어긋납니다.
둘째, 실시간 응답 속도가 중요한 서비스라면 첫 답까지의 시간(AA 기준 66초)도 따로 확인해야 합니다.
자주 묻는 질문
Q. 무료 요금제로 Carbon을 써 볼 수 있나요?
아닙니다. 앱의 무료 요금제와 API의 무료 등급 모두 제외입니다. API는 유료 등급이어야 하고, 앱은 Ultra 구독 대상입니다. AI Pro 구독자에게 열리는 시기는 발표되지 않았습니다.
Q. 한국에서 바로 쓸 수 있나요?
API(AI Studio)와 구독 앱에 대해 한국 제공 여부를 따로 밝힌 자료는 없습니다. 검색 AI 모드는 일부 국가로 제한되고 한국 제공 여부는 확인되지 않았습니다. 본인 계정의 모델 목록에서 직접 확인하는 방법이 가장 정확합니다.
Q. AA의 작업당 비용이 곧 내 업무의 비용인가요?
그렇지 않습니다. AA의 작업은 지능 지수를 재기 위한 정해진 과제입니다. 여러분의 업무와 입력 길이·난이도가 다르면 토큰 사용량과 청구액도 달라집니다.
참고 자료
- 구글 발표(정식 제공): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- The Decoder 분석: https://the-decoder.com/gemini-4-carbon-arrives-just-in-time-to-feel-like-yesterdays-news-in-the-fastest-model-cycle-yet/
- Artificial Analysis Carbon: https://artificialanalysis.ai/models/gemini-4-carbon
- 이용 범위 정리: https://www.atlascloud.ai/blog/tips/gemini-4-carbon
마무리
Carbon은 11월 10일에 문을 열었고, 11월 30일까지는 Argon과 같은 값입니다. 구글은 일상 업무에는 Argon, 한계를 시험하는 일에는 Carbon을 안내합니다. 외부 측정(AA)에서 Carbon(High)은 Argon(High)보다 점수가 높고 작업당 비용이 낮았지만, Fable 5.2(High)는 점수와 시간에서 앞서 있습니다. 설정이 다르면 비교가 성립하지 않으니, 숫자를 읽을 때는 항상 설정과 정가·기념가 기준을 함께 확인하세요.
기념가가 끝나기 전, 본인 작업으로 직접 돌려 본 청구액이 어떤 순위표보다 믿을 만한 기준입니다.
📧 sales@vizensoft.com | 🌐 www.vizensoft.com | 📞 02-338-4610




 상담요청
-

-
CONTACT US
- 제작문의210번
- 안내0번
- 장애처리9번

사업자등록번호 : 108-81-65306 | 대표자 : 김지훈
주소 : (우)08510 서울특별시 금천구 벚꽃로 298, 대륭포스트타워 6차 1307호
COPYRIGHT 2004-2026 VIZENSOFT ALL RIGHTS RESERVED.
개인정보처리방침