

Deep Insight Into
IT Technology & Trends
통찰력 있는 사람들이 함께하는 젊고 열정적인 IT 기업, 비젠메디컬.
 Back
윈도우 로컬 AI 에이전트, 내 PC에서 어디까지 맡길 수 있나
윈도우 로컬 AI 에이전트, 내 PC에서 어디까지 맡길 수 있나 - 2026년 9월 14일, Windows용 Perplexity 앱에 Portable Computer가 들어왔습
 7
# 윈도우 로컬 AI 에이전트, 내 PC에서 어디까지 맡길 수 있나
2026년 9월 기준, GeForce RTX 24GB VRAM 또는 Ryzen AI Max PC를 쓰고 있다면 Perplexity Portable Computer에서 로컬로 끝낼 일과 클라우드로 넘길 일을 가르는 기준
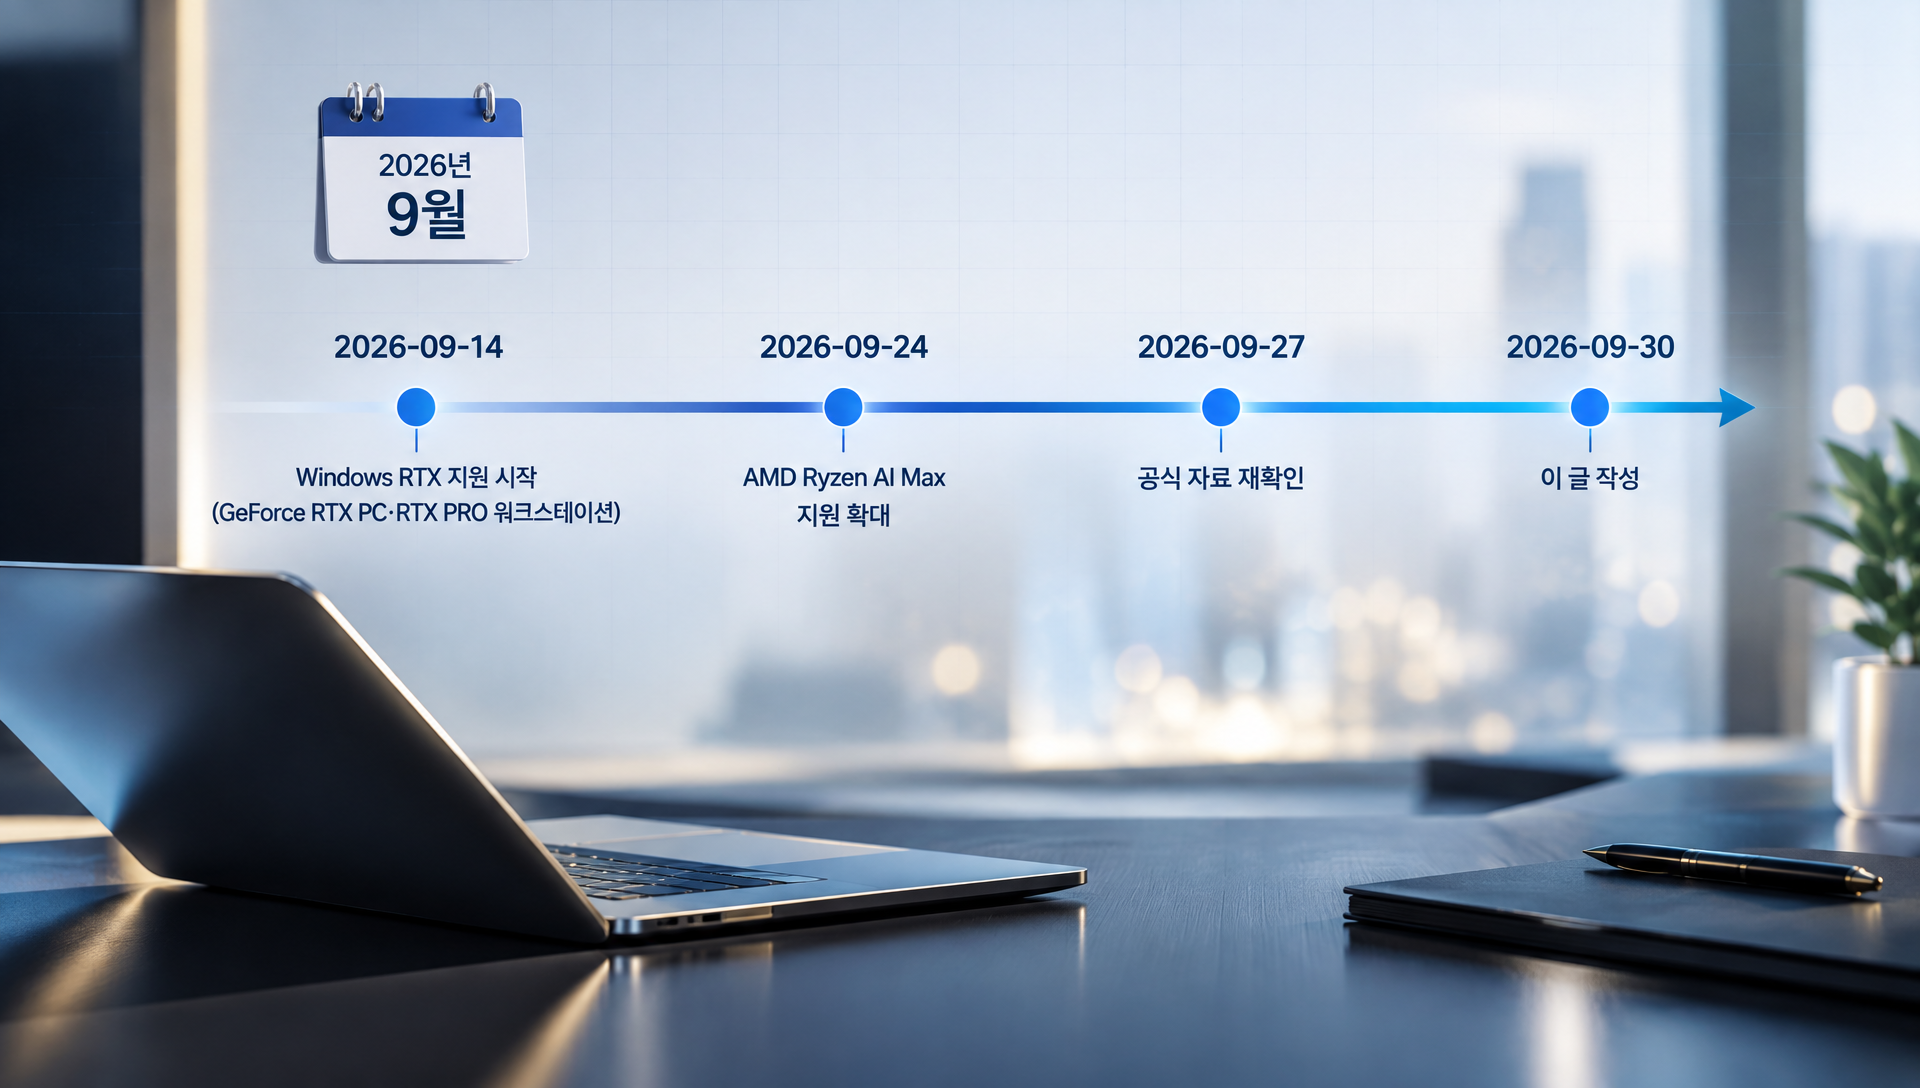
2026년 9월 14일, Windows용 Perplexity 앱에 Portable Computer가 들어왔습니다. 호환되는 GeForce RTX PC와 RTX PRO 워크스테이션이 대상입니다. 열흘 뒤인 9월 24일에는 AMD Ryzen AI Max Series 프로세서 탑재 Windows PC와 Ryzen AI Halo 개발자 플랫폼으로 지원이 넓어졌습니다. 윈도우 로컬 AI 에이전트를 완성된 제품 형태로 쓸 수 있는 길이 열린 것입니다. 이 글은 공식 자료를 2026년 9월 27일에 다시 확인해 정리했습니다.
📌 핵심 요지(TL;DR)
1. 구독만으로는 안 됩니다. Windows용 Perplexity 앱의 Pro·Max 구독에 호환 하드웨어가 더해져야 합니다.
2. 하드웨어 기준은 경로마다 다릅니다. RTX는 VRAM 24GB 이상, AMD Ryzen AI Max는 GPU에서 쓸 수 있는 메모리 24GB 이상입니다. 두 수치는 섞어 읽으면 안 됩니다.
3. 로컬에서 끝나는 일이 있습니다. 허용한 폴더 안의 문서 분석, 예약 작업, 커넥터·MCP 서버를 통한 앱 작업이 여기에 들어갑니다.
4. 클라우드로 넘어가는 일도 있습니다. 최신 웹 정보나 더 강한 추론이 필요하면 Perplexity Search나 15개 이상의 클라우드 모델로 이어지며, 기기 밖으로 보내기 전에 사용자 허가를 요청합니다.
5. PC 전체를 마음대로 제어하는 기능이 아닙니다. 예약 작업도 앱이 열려 있고 PC가 깨어 있을 때만 돌아갑니다.
아래에서는 자신의 PC가 조건을 만족하는지, 어떤 일을 로컬에 맡기고 어떤 일을 클라우드로 보낼지 순서대로 판단할 수 있게 정리합니다.
로컬 AI PC 시대의 신호: 2026년 9월 두 차례 지원 확대가 의미하는 것
로컬 AI가 모델 한 개를 돌려 보는 실험에서 일을 맡기는 에이전트로 넘어왔다는 신호가 2026년 9월에 나왔습니다. 발표는 두 단계로 이어졌습니다.
먼저 9월 14일에 Windows용 Perplexity 앱이 호환 GeForce RTX PC와 RTX PRO 워크스테이션을 대상으로 Portable Computer를 제공하기 시작했습니다. NVIDIA는 이 시점에 DGX Station 지원은 추후 제공 예정이라고 밝혔습니다. 9월 24일에는 AMD Ryzen AI Max Series 프로세서 탑재 Windows PC와 Ryzen AI Halo 개발자 플랫폼이 지원 대상에 추가됐습니다.
이번 제공이 기존 Windows 앱과 다른 점
Portable Computer는 기존 Windows 앱에 로컬 모델과 에이전트 실행 기능을 더한 것입니다. 구성은 세 갈래입니다.
① 로컬 모델: 지원 Windows PC에서는 PPLX 27B를 안내합니다.
② 에이전트 실행 구성요소: 하네스, 오케스트레이터, 플래너, 샌드박스를 지원 기기에서 실행합니다.
③ 작업 예약: 반복 작업을 설정해 기기에서 처리할 수 있습니다.
모델만 로컬로 돌리는 것과 에이전트의 계획·실행 과정 전체를 기기 안에서 돌리는 것은 다릅니다. 이번 제공은 후자에 가깝습니다. 그래서 온디바이스 AI가 채팅 답변을 로컬에서 만드는 수준을 넘어 파일 작업과 반복 업무까지 넘보게 됐습니다.
오해하기 쉬운 지점
⚠️ 이 기능을 "Windows 전체 제어 기능"으로 이해하면 안 됩니다. 공식 자료는 일반적인 Windows 전체 제어 기능과 Portable Computer를 구분합니다. 파일 작업은 사용자가 접근을 허용한 폴더가 대상이고, 다른 앱과의 연동도 설정된 커넥터와 권한을 전제로 합니다.
이용 대상은 Windows용 Perplexity 앱을 쓰는 Pro·Max 개인 및 기업 구독자입니다. 그러나 구독이 곧 로컬 실행 자격은 아닙니다. 호환 하드웨어가 있어야 하고, 그 기준이 다음 섹션의 핵심 데이터입니다.
로컬 AI PC 판정 기준: RTX 24GB VRAM과 Ryzen AI Max 24GB 메모리는 서로 다른 기준
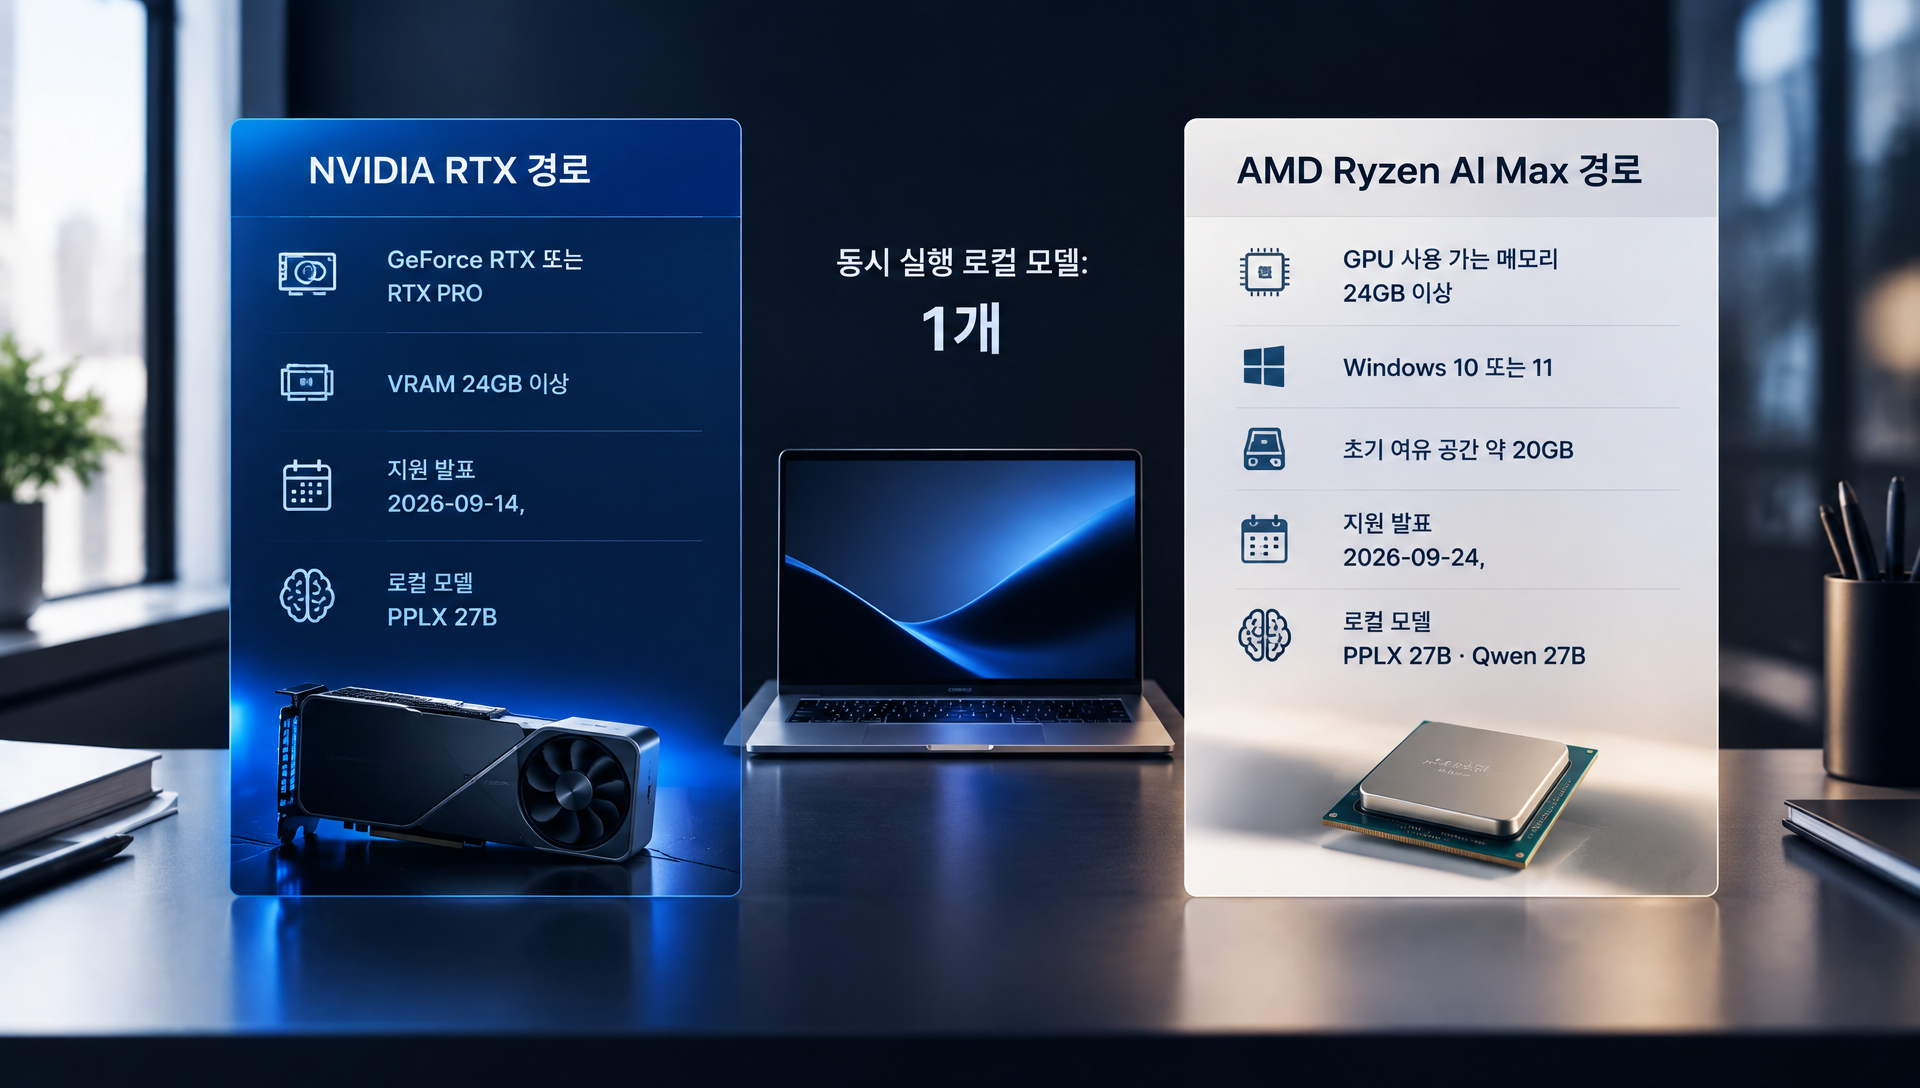
내 PC가 조건을 충족하는지는 경로별 메모리 기준으로 판단해야 하며, RTX의 VRAM 24GB와 AMD의 GPU 사용 가능 메모리 24GB는 같은 기준이 아닙니다. 숫자는 같아도 측정 대상이 다릅니다. RTX 경로는 GPU 전용 메모리 용량이 기준입니다. AMD Ryzen AI Max 경로는 GPU가 쓸 수 있는 메모리 24GB 이상이 기준이며, 여기에 OS와 초기 저장공간 요건이 함께 안내돼 있습니다.
| 구분 | NVIDIA RTX 경로 | AMD Ryzen AI Max 경로 |
|---|---|---|
| 지원 발표일 | 2026년 9월 14일 | 2026년 9월 24일 |
| 대상 하드웨어 | GeForce RTX PC, RTX PRO 워크스테이션 | Ryzen AI Max Series 탑재 Windows PC, Ryzen AI Halo 개발자 플랫폼 |
| 메모리 기준 | GPU VRAM 24GB 이상 | GPU에서 사용 가능한 메모리 24GB 이상 |
| OS·초기 저장공간 | 확인한 자료에 별도 수치 없음(공식 안내 확인 필요) | Windows 10 또는 11, 약 20GB 여유 공간 |
| 로컬 모델 안내 | PPLX 27B (Qwen은 공식 자료 간 표현이 엇갈려 단정 불가) | PPLX 27B, Qwen 27B |
| 동시 실행 | 한 번에 1개 모델 | 한 번에 1개 모델 |
| 클라우드 추론 선택지 | 15개 이상 모델 | 15개 이상 모델 |
내 PC 확인 방법
RTX PC라면 작업 관리자의 성능 탭에서 GPU 항목을 열어 전용 GPU 메모리를 확인합니다. 명령 프롬프트에서 `nvidia-smi`를 실행해 총 메모리를 확인해도 됩니다. 24GB 미만이면 RTX 경로의 최소 요건에 미달합니다.
Ryzen AI Max PC라면 GPU에서 쓸 수 있는 메모리가 24GB 이상인지 봐야 합니다. 시스템 메모리 총량이 아니라 GPU가 실제로 사용할 수 있는 몫이 기준입니다. 작업 관리자와 제조사 사양 문서를 함께 확인하세요. 이어서 Windows 버전이 10 또는 11인지, 초기 설치용 여유 공간이 약 20GB 이상인지도 봅니다.
모델 안내의 차이와 표현이 엇갈리는 부분
2026년 9월 제품 페이지는 지원 Windows PC의 로컬 모델로 PPLX 27B를 안내하고, 한 번에 실행할 수 있는 로컬 모델은 1개라고 명시합니다. AMD Ryzen AI Max 경로에는 PPLX 27B와 Qwen 27B가 안내돼 있습니다.
Windows RTX에서의 Qwen 이용 가능 여부는 공식 자료 간 표현이 엇갈립니다. 제품 페이지에서 Qwen 3.8 27B가 제공되지 않는다고 적은 부분은 Windows가 아니라 Linux RTX PC에 관한 내용입니다. Linux RTX도 VRAM 24GB 이상이고 로컬 모델은 PPLX 27B입니다. 반면 NVIDIA 발표문은 Qwen 3.8 27B를 RTX GPU에 최적화된 로컬 모델 사례로 언급합니다. 따라서 Windows RTX에서 Qwen을 쓸 수 있다거나 없다고 단정하지 말고, 설치 전에 앱 안의 모델 목록을 직접 확인하세요.
AI 에이전트 PC 시장의 세 플레이어 계층: 앱, 하드웨어, 개발 플랫폼
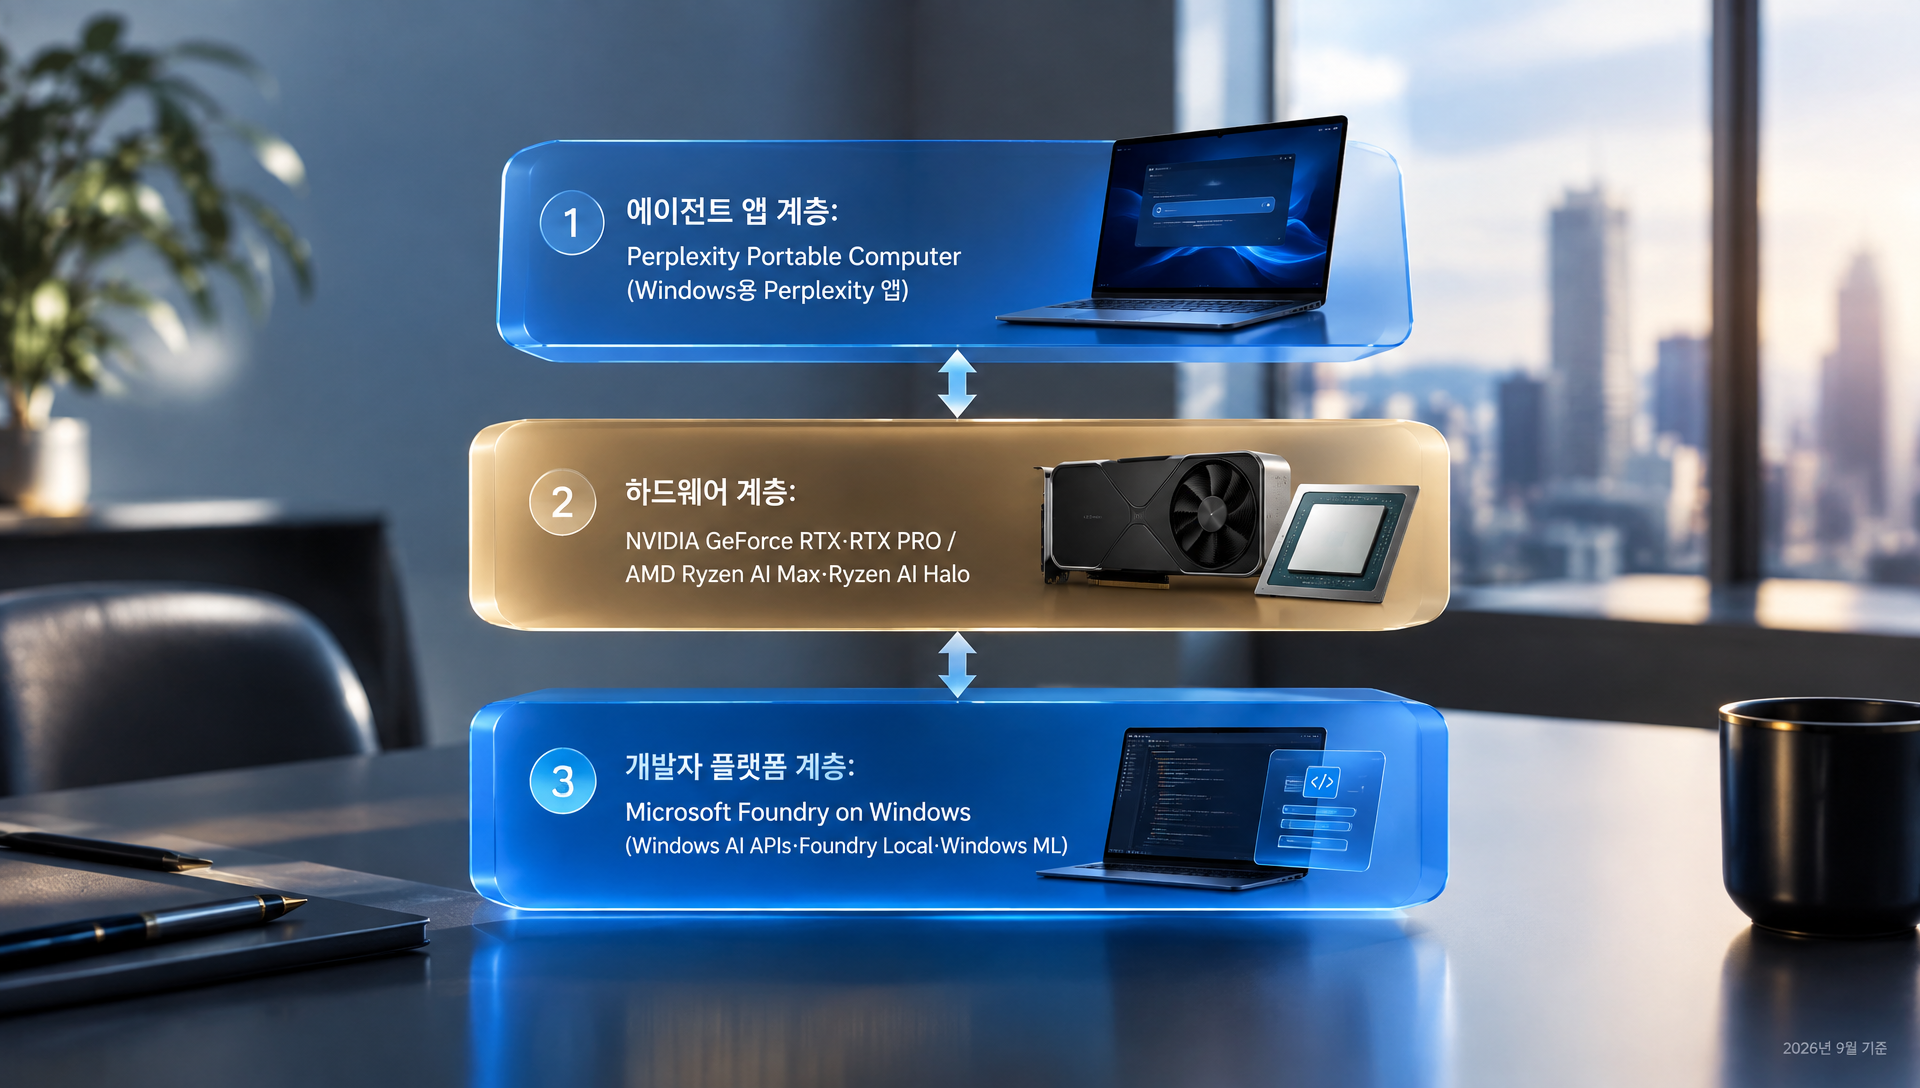
AI 에이전트 PC 시장은 에이전트 앱, 하드웨어, 개발자용 플랫폼의 세 계층으로 나눠 봐야 각자의 역할이 보입니다. 한 회사가 전부 하는 구조가 아니라 계층마다 다른 주체가 움직입니다.
에이전트 앱 계층: 완성형 제품
이 계층의 대표 사례가 Perplexity의 Portable Computer입니다. 모델, 에이전트 하네스, 오케스트레이터, 플래너, 샌드박스, 작업 예약, 커넥터를 하나의 앱 경험으로 묶었습니다. 사용자는 모델을 따로 구해 도구와 이어 붙이지 않아도 됩니다. 대신 앱이 정한 모델(PPLX 27B 등)과 권한 체계 안에서 움직입니다.
같은 계층에는 클라우드 중심 에이전트 서비스도 있습니다. 이들은 높은 추론 성능을 내세우는 대신 작업 데이터가 서버를 거칩니다. 그리고 오픈소스 로컬 실행 도구는 자유도가 높은 대신 설치, 모델 선택, 권한 설계를 사용자가 직접 맡아야 합니다. Portable Computer는 이 사이에서 로컬 실행과 클라우드 연결을 한 앱 안에 묶은 하이브리드형으로 볼 수 있습니다.
하드웨어 계층: 메모리가 자격을 가른다
NVIDIA는 GeForce RTX PC와 RTX PRO 워크스테이션을 앞세운 NVIDIA RTX AI 경로를, AMD는 Ryzen AI Max Series와 Ryzen AI Halo 개발자 플랫폼 경로를 맡습니다. 두 경로 모두 24GB 이상의 메모리를 요구한다는 점이 같습니다. 에이전트 PC의 자격이 연산 성능이 아니라 GPU가 쓸 수 있는 메모리 용량에서 갈린다는 뜻입니다. DGX Station은 NVIDIA가 추후 제공 예정이라고 밝힌 상태입니다.
개발자 플랫폼 계층: 혼동하면 안 되는 Microsoft의 선택지
Microsoft Foundry on Windows는 Windows AI APIs, Foundry Local, Windows ML로 구성됩니다. 앱 개발자가 로컬 AI를 자기 앱에 통합하거나 모델을 실행하기 위한 플랫폼 선택지입니다. Microsoft는 Windows AI APIs의 대부분이 Copilot+ PC를 대상으로 하고, Foundry Local과 Windows ML은 Windows 10 이후 기기에서도 쓸 수 있다고 구분합니다.
이 플랫폼들은 Perplexity Portable Computer 같은 완성형 PC 에이전트가 아닙니다. 그렇다고 모든 Windows PC의 자동화 권한을 뜻하지도 않습니다. 개발자라면 앱에 로컬 AI를 넣는 재료로, 일반 사용자라면 완성형 앱을 고르는 기준과는 별개의 층으로 이해하면 됩니다.
변화 요인 ① 기술: 27B 모델과 온디바이스 실행 구조가 만든 가능성
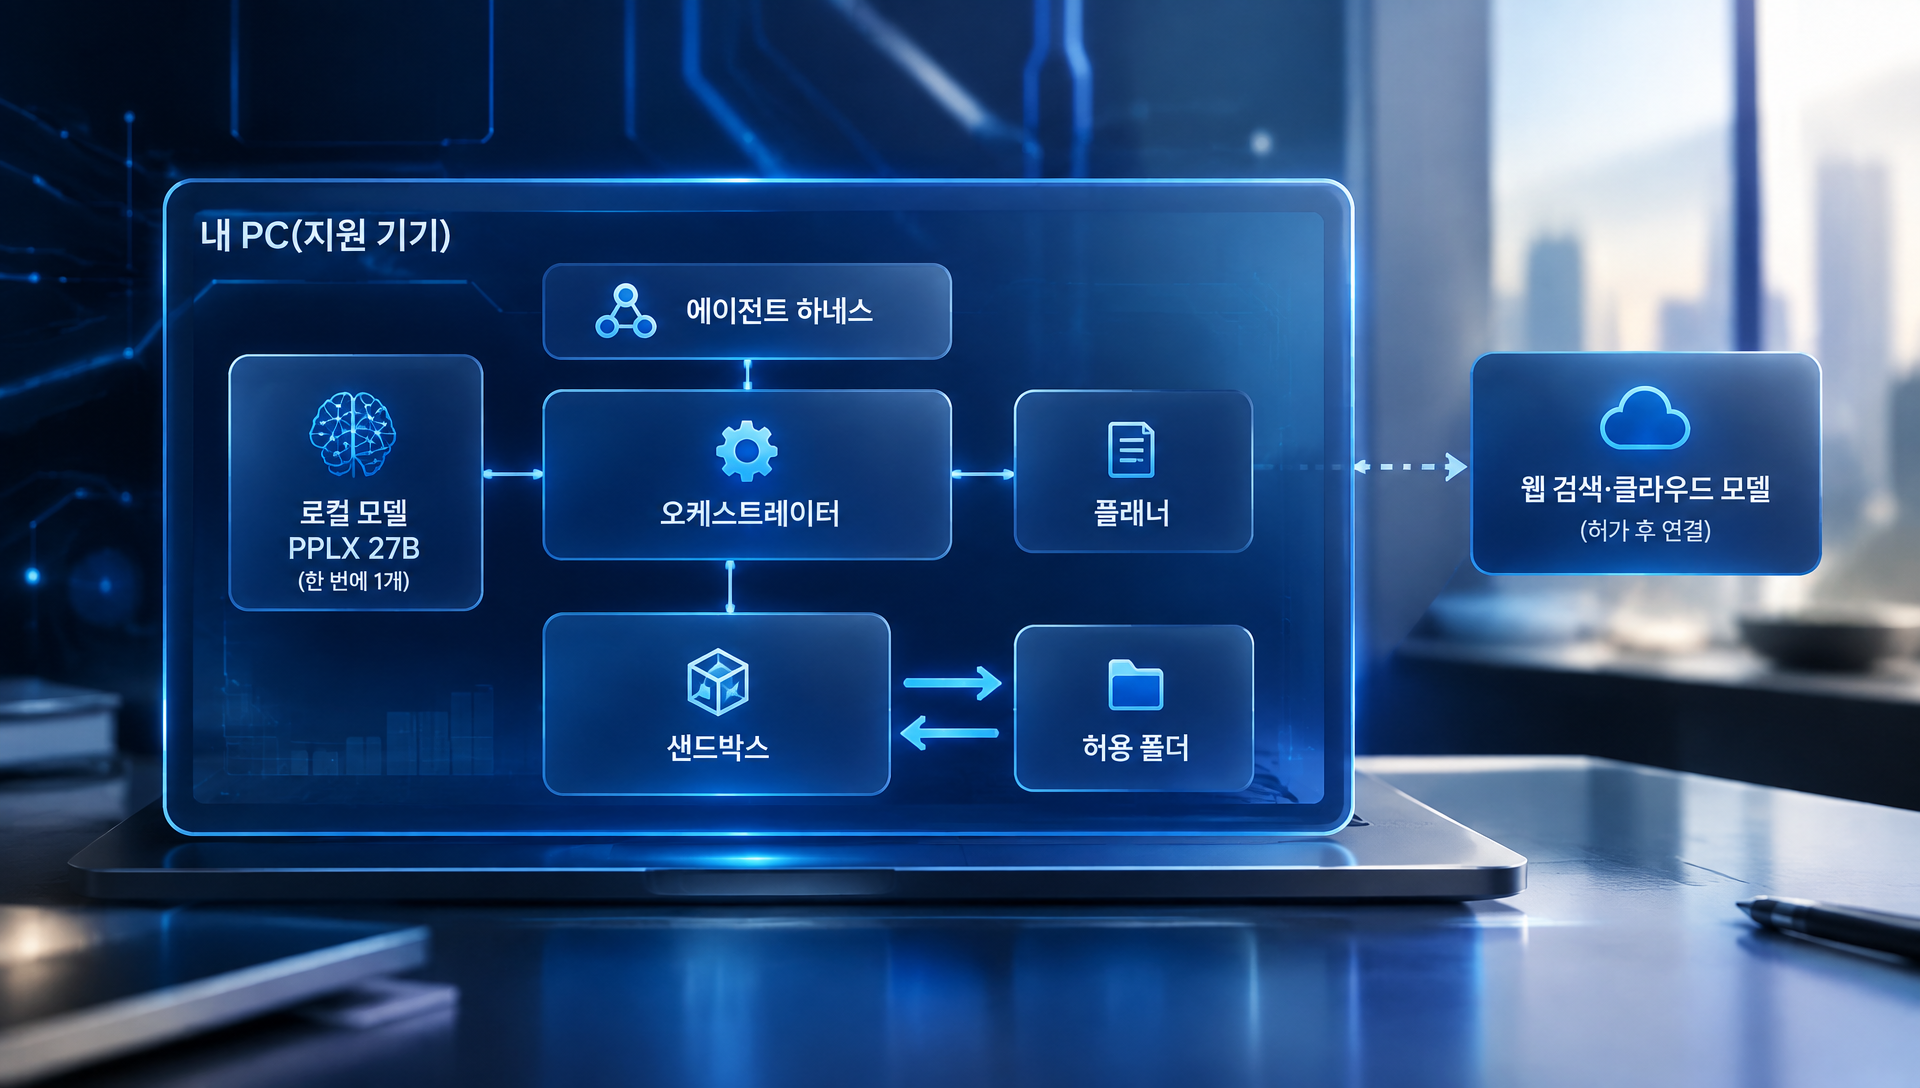
에이전트가 로컬에서 돌 수 있게 된 것은 27B급 모델을 올릴 메모리와, 모델 밖에서 일을 관리하는 실행 구조가 함께 갖춰졌기 때문입니다. 공식 자료는 모델과 함께 하네스, 오케스트레이터, 플래너, 샌드박스가 지원 기기에서 실행된다고 안내합니다.
에이전트를 구성하는 네 가지 요소
각 요소의 역할은 다음과 같이 이해하면 됩니다. 아래 역할 설명은 일반적인 에이전트 구조에 기댄 해석이며, 세부 구현은 공식 문서를 확인하세요.
① 하네스: 모델이 도구와 파일, 결과를 주고받도록 감싸는 실행 틀입니다.
② 오케스트레이터: 여러 단계의 작업을 순서대로 이어 가도록 조율합니다.
③ 플래너: 요청을 하위 작업으로 쪼개 계획을 세웁니다.
④ 샌드박스: 코드와 도구 실행을 격리된 공간에서 처리합니다. 파일 읽기·쓰기 범위는 허용 폴더로 제한된다고 안내돼 있습니다.
24GB 요건을 읽는 법
경로마다 24GB 이상의 메모리를 요구하는 것은 270억 개 규모 모델을 GPU 메모리에 올려 둬야 하기 때문이라고 보는 것이 자연스럽습니다. 이 또한 해석이며, 공식 자료가 이유를 자세히 설명한 것은 아닙니다. 분명한 것은 메모리가 부족하면 이 경로 자체가 열리지 않는다는 점입니다.
한 번에 실행할 수 있는 로컬 모델이 1개라는 제약도 같은 맥락으로 이해됩니다. 모델을 여러 개 상주시키기 어려운 환경이라 작업 성격에 따라 모델을 바꿔 쓰는 방식이 됩니다.
MCP와 커넥터
Gmail, Outlook, Slack, GitHub 커넥터가 안내돼 있고, 같은 PC의 지원 앱은 사용자가 설정한 로컬 MCP 서버를 통해 연동할 수 있습니다. MCP는 AI가 외부 도구와 앱에 표준 방식으로 접근하게 하는 규약입니다. 핵심은 이 연동이 설정된 커넥터와 권한을 전제로 한다는 점입니다. 연결하지 않은 앱은 만지지 못합니다.
Windows 개발자 플랫폼과의 관계
Foundry Local과 Windows ML은 Windows 10 이후 기기에서 쓸 수 있고, Windows AI APIs 대부분은 Copilot+ PC 대상입니다. 이들은 개발자가 앱에 로컬 AI를 넣는 기술적 토대입니다. 완성형 에이전트의 필요조건이나 대체재가 아니라 다른 층의 기술로 봐야 합니다.
변화 요인
② 시장: 크레딧 구조, 개인정보 부담, 하이브리드 수요가 로컬 AI를 밀고 있다
로컬 AI 에이전트가 주목받는 시장적 이유는 비용 구조, 데이터 통제 욕구, 하이브리드 처리의 현실성 세 가지로 요약됩니다. 아래 내용은 공식 안내를 바탕으로 한 해석이며, 시장 규모 수치는 검증된 출처가 없어 다루지 않습니다.
비용 구조의 변화
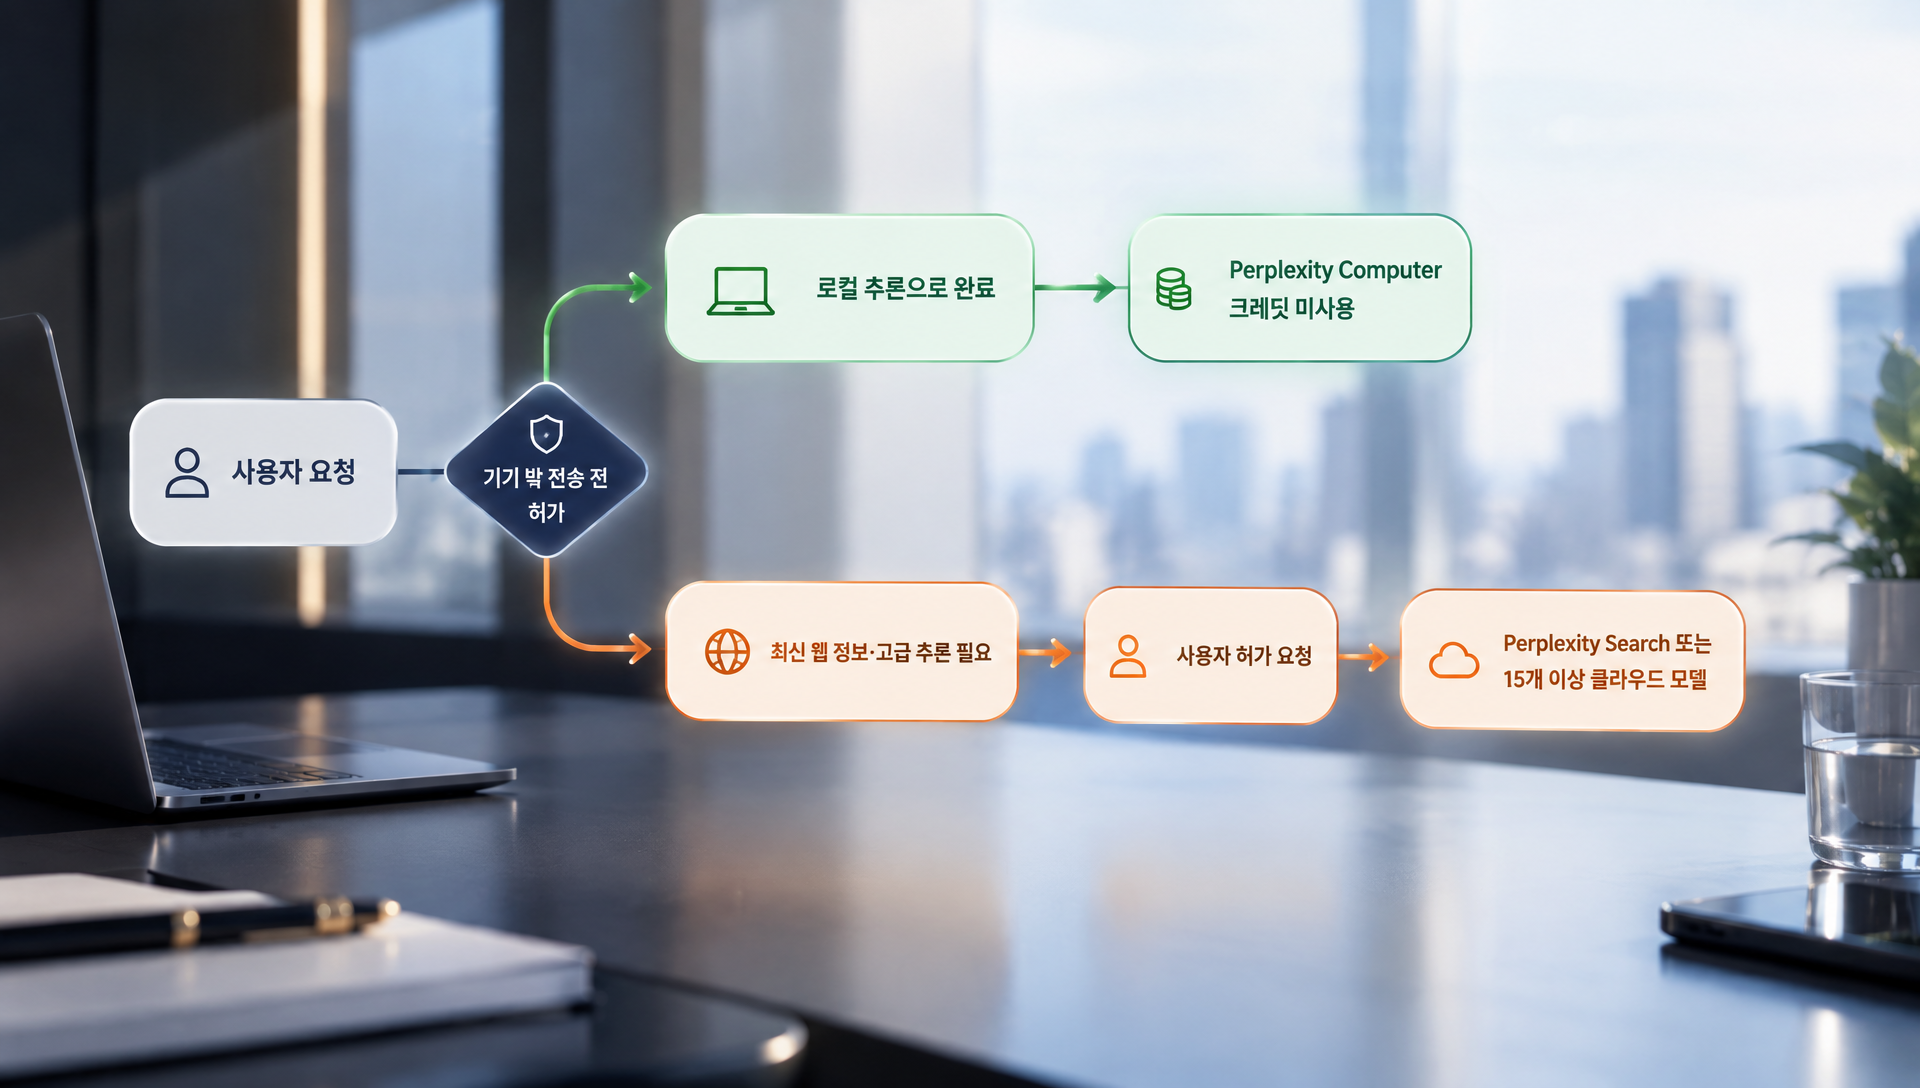
로컬 추론으로 끝난 작업은 Perplexity Computer 크레딧을 쓰지 않습니다. 반복 작업이 많을수록 이 차이는 커집니다. 매일 돌리는 문서 요약이나 폴더 정리를 클라우드 크레딧으로 처리하면 사용량이 곧 비용이 됩니다. 로컬은 이미 가진 하드웨어를 쓰는 구조라 사용량에 따른 크레딧 부담이 없습니다.
다만 이것이 곧 총비용이 낮다는 뜻은 아닙니다. 24GB 이상의 메모리를 갖춘 하드웨어라는 선투자가 전제이고, 구독 자격도 필요합니다. 하드웨어를 이미 갖고 있는지가 손익을 가릅니다.
데이터 통제 욕구
계약서, 재무 자료, 소스 코드처럼 밖으로 내보내기 꺼려지는 자료가 있습니다. 로컬 실행은 이런 자료를 허용한 폴더 안에서 기기 내 처리로 끝낼 수 있는 길을 열어 줍니다. 그러나 여기서 "로컬 처리만 하면 모든 데이터가 항상 기기를 떠나지 않는다"고 결론짓는 것은 정확하지 않습니다. 작업 중 웹 정보나 고급 추론이 필요해지면 클라우드 단계로 이어질 수 있고, 그때는 사용자에게 허가를 요청한다고 회사가 설명합니다. 허가 화면이 나오는 순간이 곧 데이터가 경계를 넘는 지점입니다.
하이브리드가 기본값이 되는 이유
로컬 27B급 모델은 문서 정리나 반복 처리에는 충분해도, 최신 웹 정보 확인이나 복잡한 추론에서는 한계가 있을 수 있습니다. 그래서 필요한 순간에 Perplexity Search나 15개 이상의 클라우드 모델로 넘기는 구조가 현실적입니다. 사용자는 "전부 로컬 아니면 전부 클라우드"를 고르는 대신, 작업 단위로 처리 위치를 정하는 방식을 택하게 됩니다.
공식 자료로 읽는 설계 원칙: 허용 폴더, 샌드박스, 승인 절차가 신뢰의 기준선
이 제품에 대해 독립적인 전문가 평가가 충분히 쌓였다고 보기는 이르므로, 지금 판단 근거는 회사가 공식 자료에서 밝힌 설계 원칙입니다. 출시 시점이 2026년 9월이라 검증 사례도 아직 많지 않습니다. 그래서 외부 발언을 임의로 인용하지 않고, 공식 안내에서 확인되는 원칙을 요약합니다.
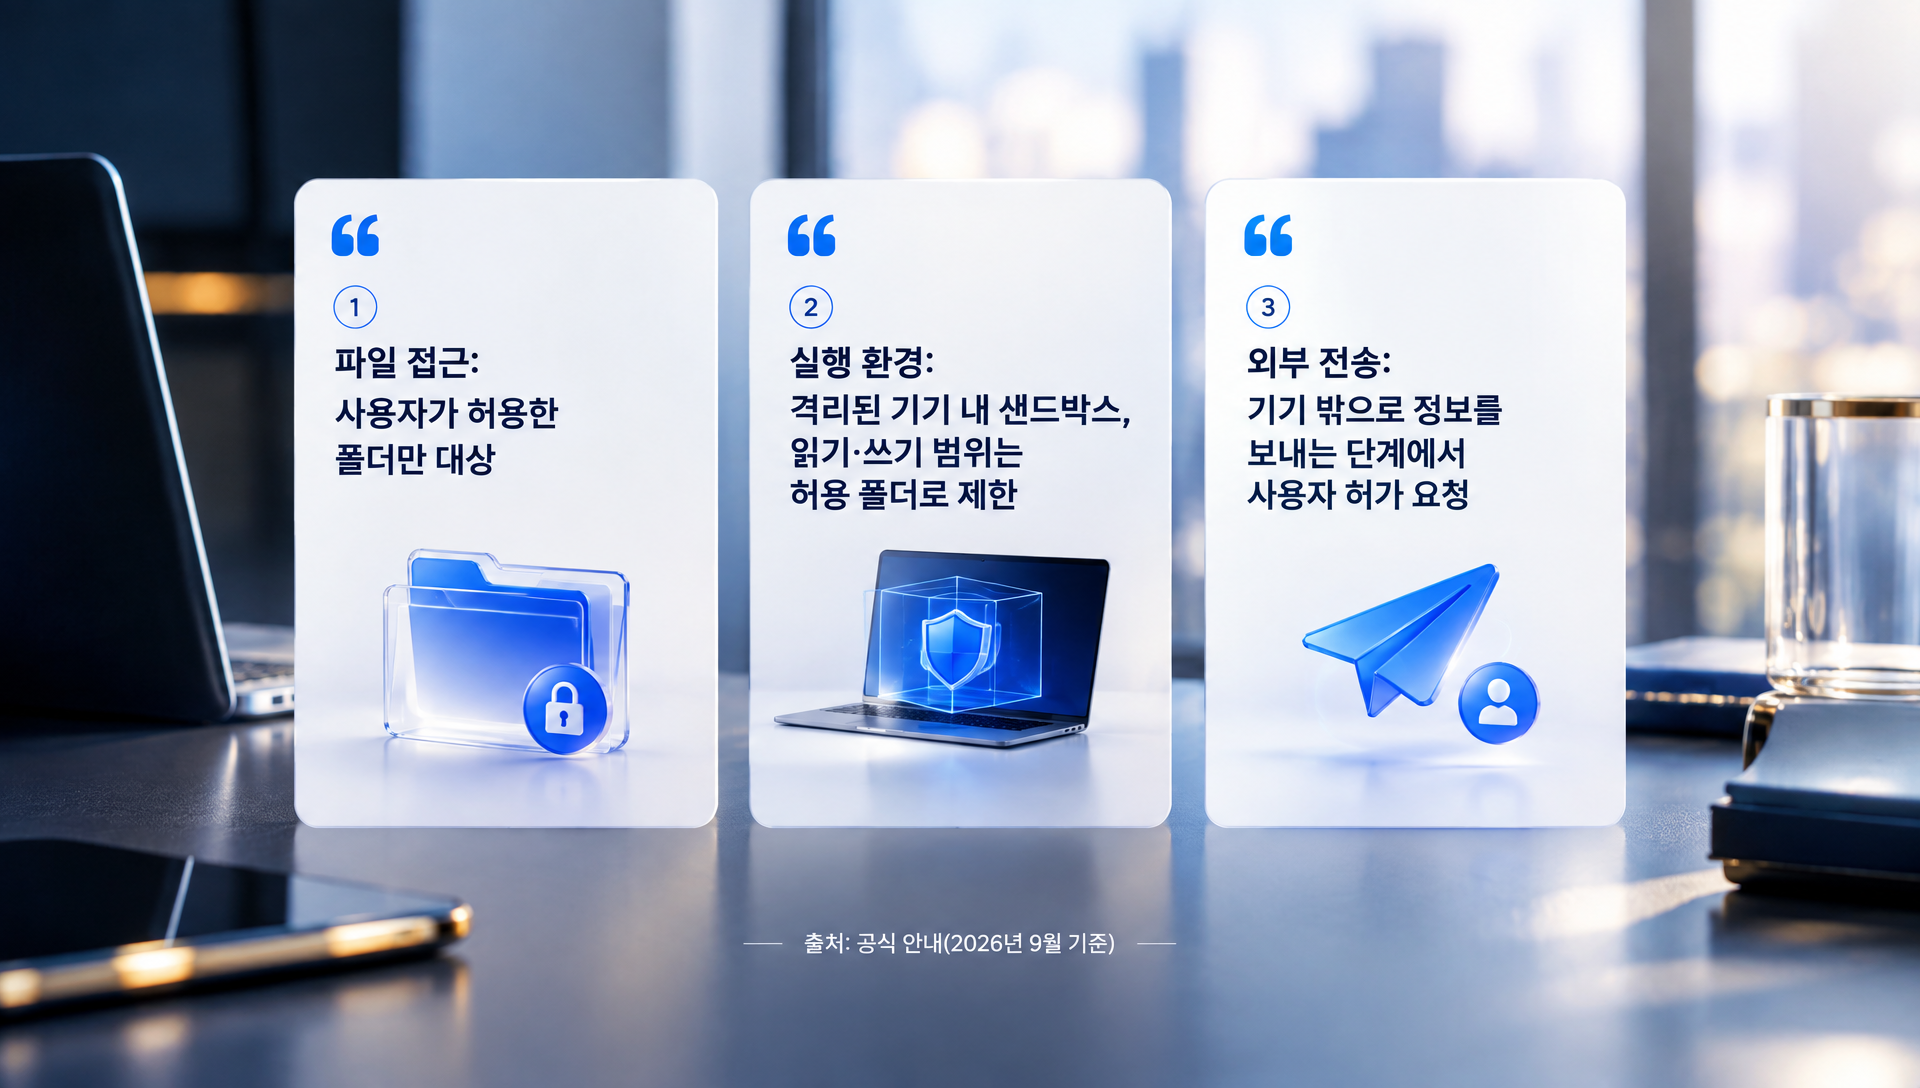
공식 안내에서 확인되는 세 가지 원칙
첫째, 파일은 허용한 폴더만 다룹니다. 문서, 스프레드시트, 프레젠테이션, PDF, 코드, 이미지 등을 다룰 수 있지만 범위는 사용자가 접근을 허용한 폴더입니다. 허용 범위 밖의 파일까지 자동으로 읽는다는 뜻이 아닙니다.
둘째, 코드와 도구 실행은 격리된 기기 내 샌드박스에서 이뤄집니다. 파일 읽기·쓰기 범위도 허용 폴더로 제한된다고 안내돼 있습니다.
셋째, 기기 밖으로 정보를 보내는 단계에서는 사용자 허가를 요청합니다.
민감정보 분류기: 어디까지 믿을 것인가
회사는 민감정보 분류기가 내용을 살핀 뒤 공유, 로컬 처리, 중단 중에서 선택할 수 있게 한다고 설명합니다. 유용한 안전장치입니다. 그러나 이를 모든 위험을 막는 보안 보장으로 읽으면 안 됩니다. 분류기의 판단이 완벽하다는 근거는 공식 자료에 없습니다. 예를 들어 어떤 자료가 민감하다고 분류되지 않으면 사용자의 판단이 최종 방어선이 됩니다.
독자가 취할 태도
이 구조를 쓸 때는 두 가지를 기억하세요. 하나, 허용 폴더에는 작업에 필요한 자료만 넣습니다. 둘, 허가 창이 뜨면 무엇이 밖으로 나가는지 읽고 승인합니다. 권한을 좁게 주고, 승인은 내용을 보고 하는 습관이 기술적 안전장치보다 먼저입니다.
향후 6~12개월 전망: DGX Station 지원, 모델 안내 정리, 지원 범위 확대가 관전 포인트
앞으로 6~12개월은 지원 범위가 넓어지고 공식 안내의 모호한 부분이 정리되는 기간이 될 가능성이 높습니다. 아래는 전망이며 확정된 로드맵이 아닙니다. 확인된 사실은 DGX Station 지원이 추후 제공 예정이라는 NVIDIA의 언급 하나입니다.
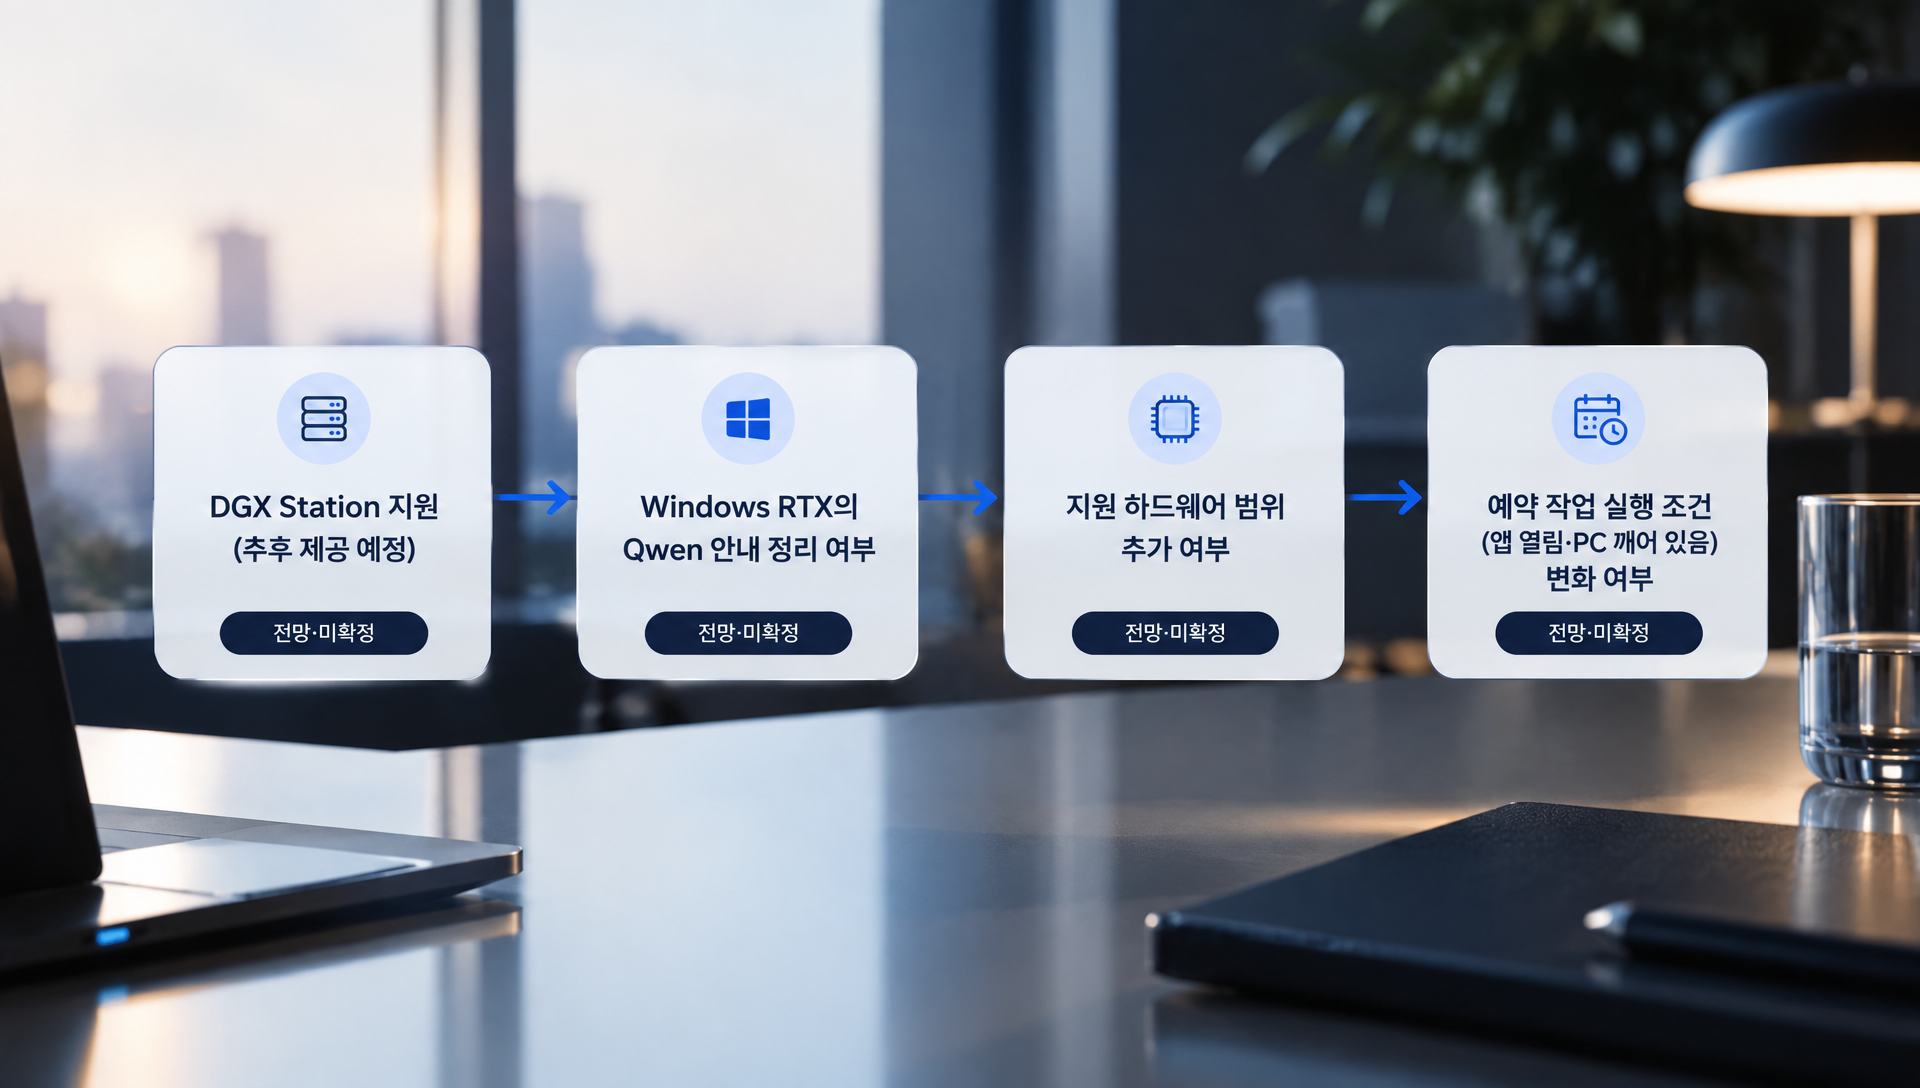
지켜볼 네 가지 신호
① DGX Station 지원의 실제 시점: 추후 제공 예정으로만 알려져 있어 시기와 조건은 미정입니다.
② Windows RTX의 Qwen 안내 정리: 지금은 제품 페이지와 NVIDIA 발표문의 표현이 엇갈립니다. 어느 쪽으로든 정리되면 모델 선택 폭이 분명해집니다.
③ 지원 하드웨어의 추가 확대: AMD가 열흘 만에 추가됐듯 다른 경로가 더해질 수 있습니다. 24GB라는 문턱이 낮아질지도 관건입니다.
④ 예약 작업의 실행 조건: 지금은 앱이 열려 있고 PC가 깨어 있을 때 실행됩니다. 이 조건이 바뀌는지 봐야 합니다. 현재로서는 "PC가 꺼져 있어도 계속 일하는 상시 에이전트"라고 부를 근거가 확인되지 않았습니다.
시나리오별 대응
보수적 시나리오에서는 지원 대상이 지금 수준에 머물고 앱 개선이 중심이 됩니다. 이 경우 이미 조건을 갖춘 사용자가 문서 분석과 반복 작업 위주로 쓰면서 노하우를 쌓는 기간이 됩니다.
확장 시나리오에서는 지원 하드웨어와 모델 선택지가 늘어납니다. 그때는 자기 PC의 메모리 기준과 모델 안내를 다시 확인하면 됩니다.
어느 쪽이든 지금 할 수 있는 일은 같습니다. 작은 범위의 파일럿으로 로컬로 충분한 작업의 목록을 만들어 두는 것입니다. 정책이나 하드웨어가 바뀌어도 이 목록이 판단의 기준이 됩니다.
향후 3~5년 시나리오: 온디바이스 AI가 기본값이 되고 메모리가 PC 선택 기준이 된다
3~5년 뒤에는 온디바이스 AI가 기본 처리 계층이 되고 클라우드가 보완 계층으로 자리 잡는 하이브리드 구조가 일반화될 가능성이 있습니다. 이 역시 전망이며, 구체적 시점이나 점유율은 검증 가능한 자료가 없어 제시하지 않습니다.
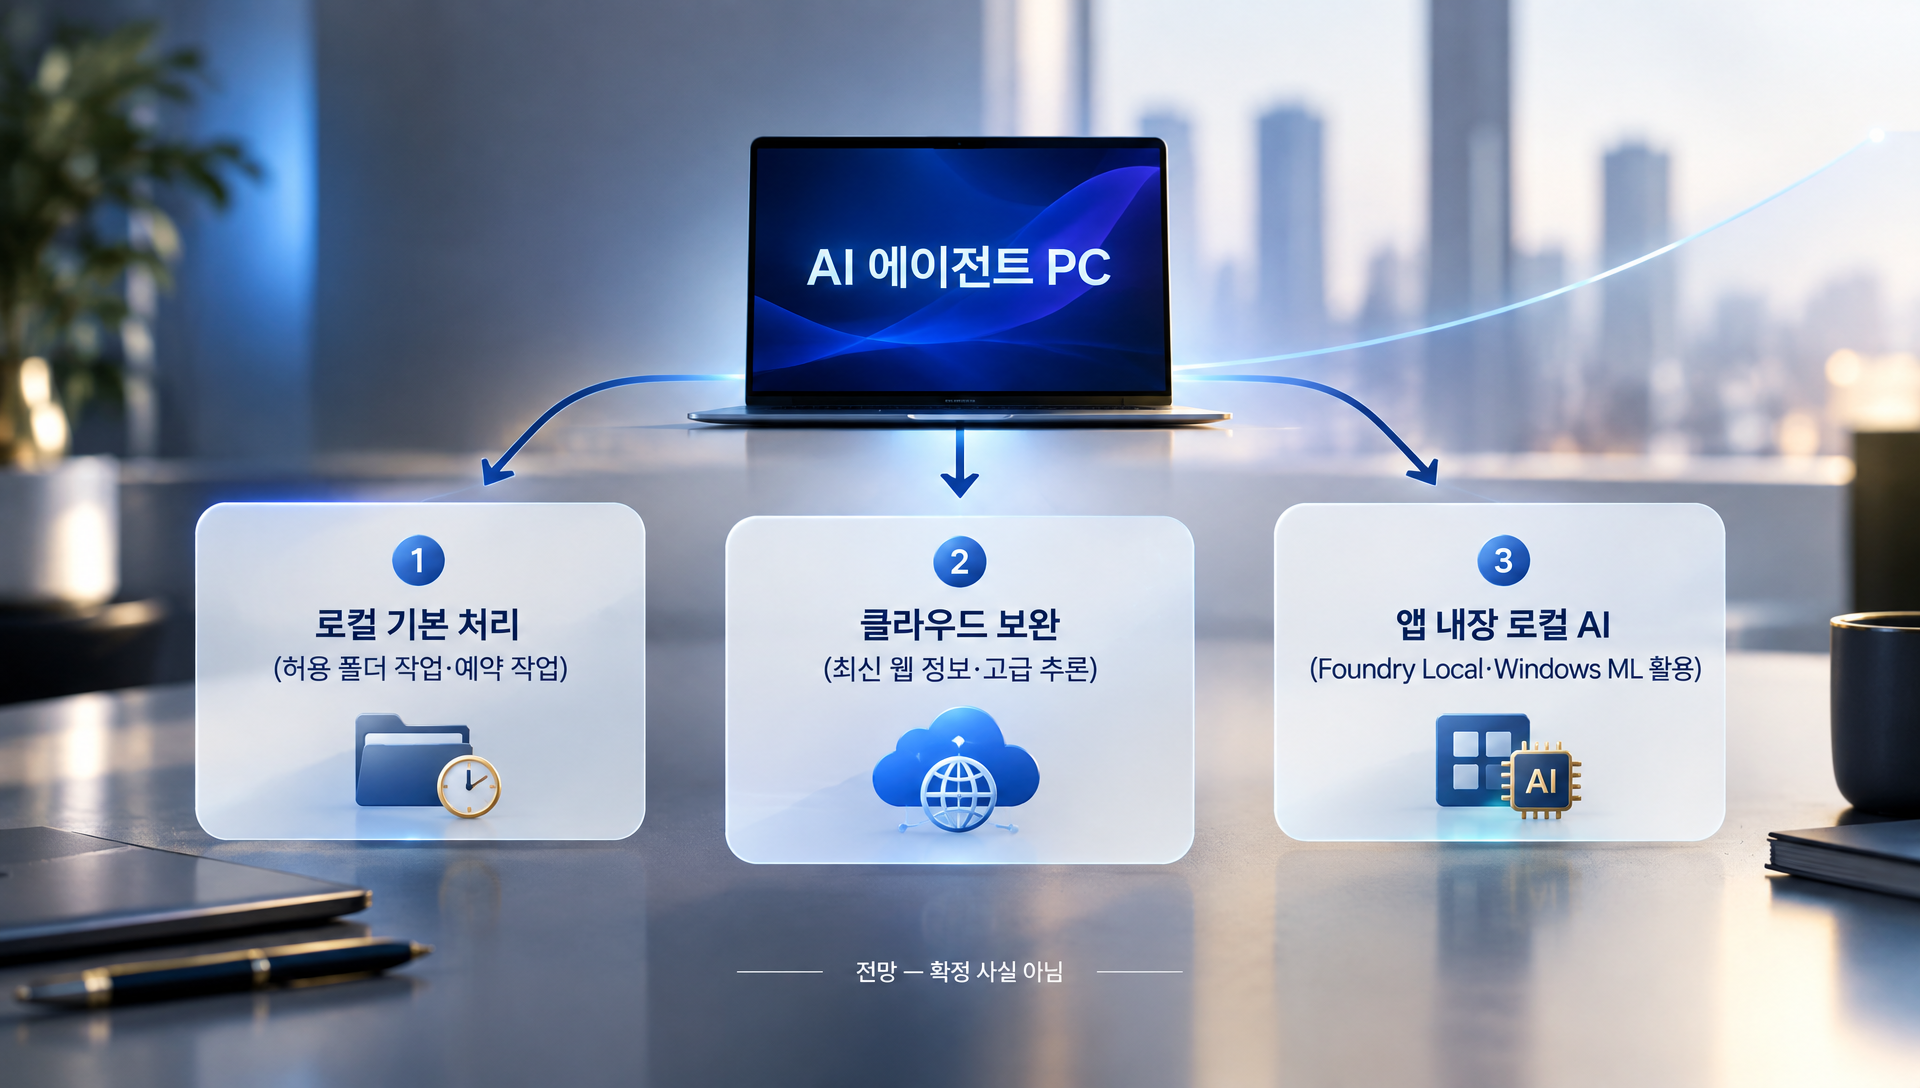
전망 ① 메모리가 PC 사양의 핵심 항목이 된다
이번 지원 조건이 24GB 이상의 메모리라는 점은 시사적입니다. 앞으로 에이전트 기능이 PC 제품의 일부가 되면, CPU 코어 수보다 GPU가 쓸 수 있는 메모리 용량이 구매 기준으로 부각될 수 있습니다. RTX 경로의 VRAM과 AMD 경로의 GPU 사용 가능 메모리가 서로 다른 측정 방식이라는 점도, 그때 비교 기준을 통일하는 문제로 이어질 수 있습니다.
전망
② 앱 안으로 들어가는 로컬 AI
Microsoft Foundry on Windows의 Foundry Local과 Windows ML은 Windows 10 이후 기기에서 쓸 수 있는 개발자용 선택지입니다. 이런 플랫폼이 자리 잡으면, 사용자가 에이전트 앱을 따로 설치하지 않아도 평소 쓰는 앱 안에서 로컬 AI 기능이 동작하는 경우가 늘어날 수 있습니다. 다만 이것은 완성형 PC 에이전트와는 다른 경로이며, 자동화 권한 문제도 별개로 다뤄야 합니다.
전망
③ 권한 설계가 경쟁력이 된다
에이전트가 하는 일이 늘수록 무엇을 허용하고 무엇을 막을지가 중요해집니다. 허용 폴더, 커넥터, MCP 서버, 클라우드 전송 승인 같은 요소는 지금도 있지만, 앞으로는 권한을 얼마나 세밀하고 이해하기 쉽게 제어할 수 있는지가 제품 선택의 기준이 될 수 있습니다. 반대로 권한이 과하게 열린 설정이 사고로 이어질 위험도 함께 커집니다.
로컬 AI 에이전트 도입 실행 가이드: 조건 확인, 폴더 설계, 승인 습관
바로 시도해 볼 수 있는 순서는 하드웨어 확인, 허용 폴더 설계, 로컬·클라우드 분류 규칙 정하기, 예약 작업 조건 점검입니다.
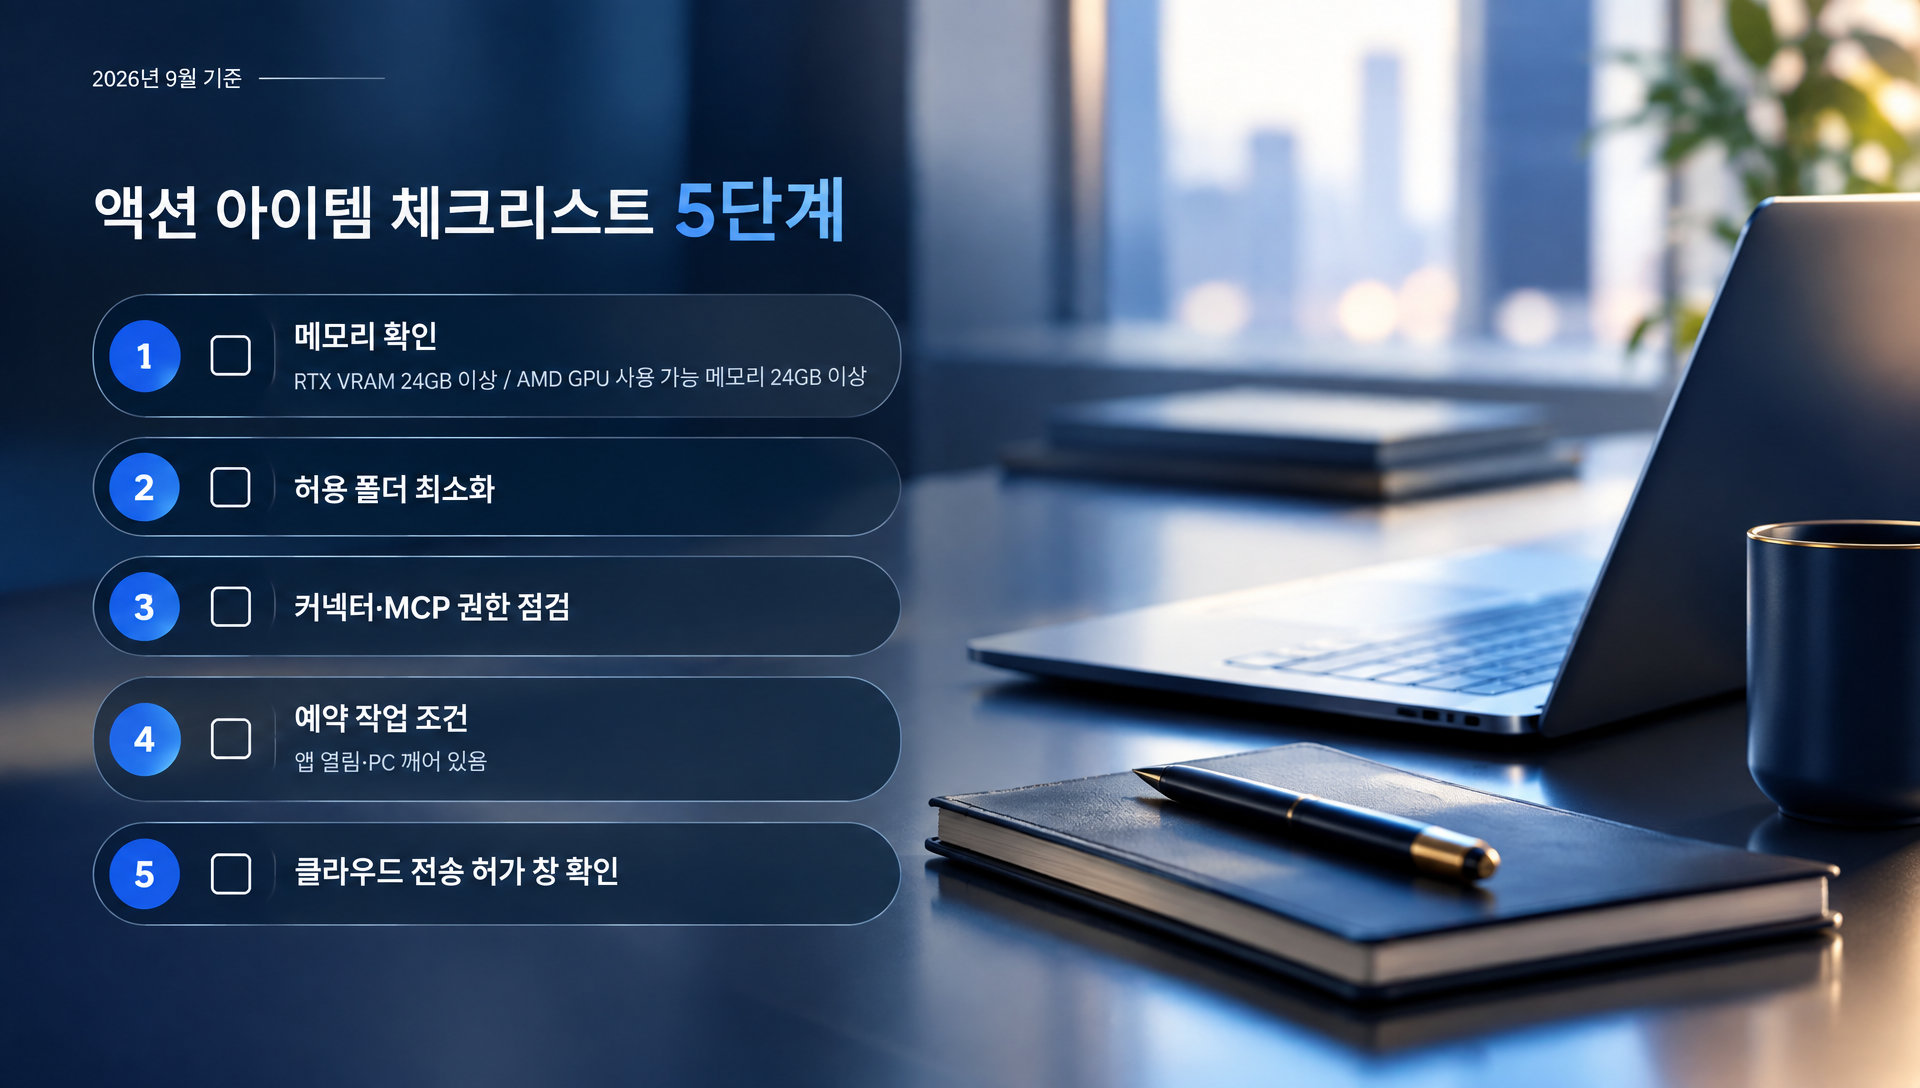
1단계, 조건 확인: RTX는 VRAM 24GB 이상, AMD는 GPU 사용 가능 메모리 24GB 이상, Windows 10 또는 11, 약 20GB 여유 공간을 확인합니다.
2단계, 허용 폴더 설계: 작업용 폴더를 따로 만들고 필요한 자료만 넣습니다. 민감한 원본은 두지 않습니다.
3단계, 분류 규칙 정하기: 문서 정리와 요약 같은 반복 작업은 로컬로, 최신 웹 정보가 필요한 조사는 클라우드로 넘긴다는 기준을 미리 정합니다.
4단계, 예약 작업 점검: 앱이 열려 있고 PC가 깨어 있어야 실행되므로, 절전 설정과 실행 시간대를 맞춥니다.
5단계, 승인 습관 들이기: 허가 창이 뜨면 무엇이 밖으로 나가는지 읽고 승인합니다. 연동은 필요한 커넥터부터 하나씩 켭니다.
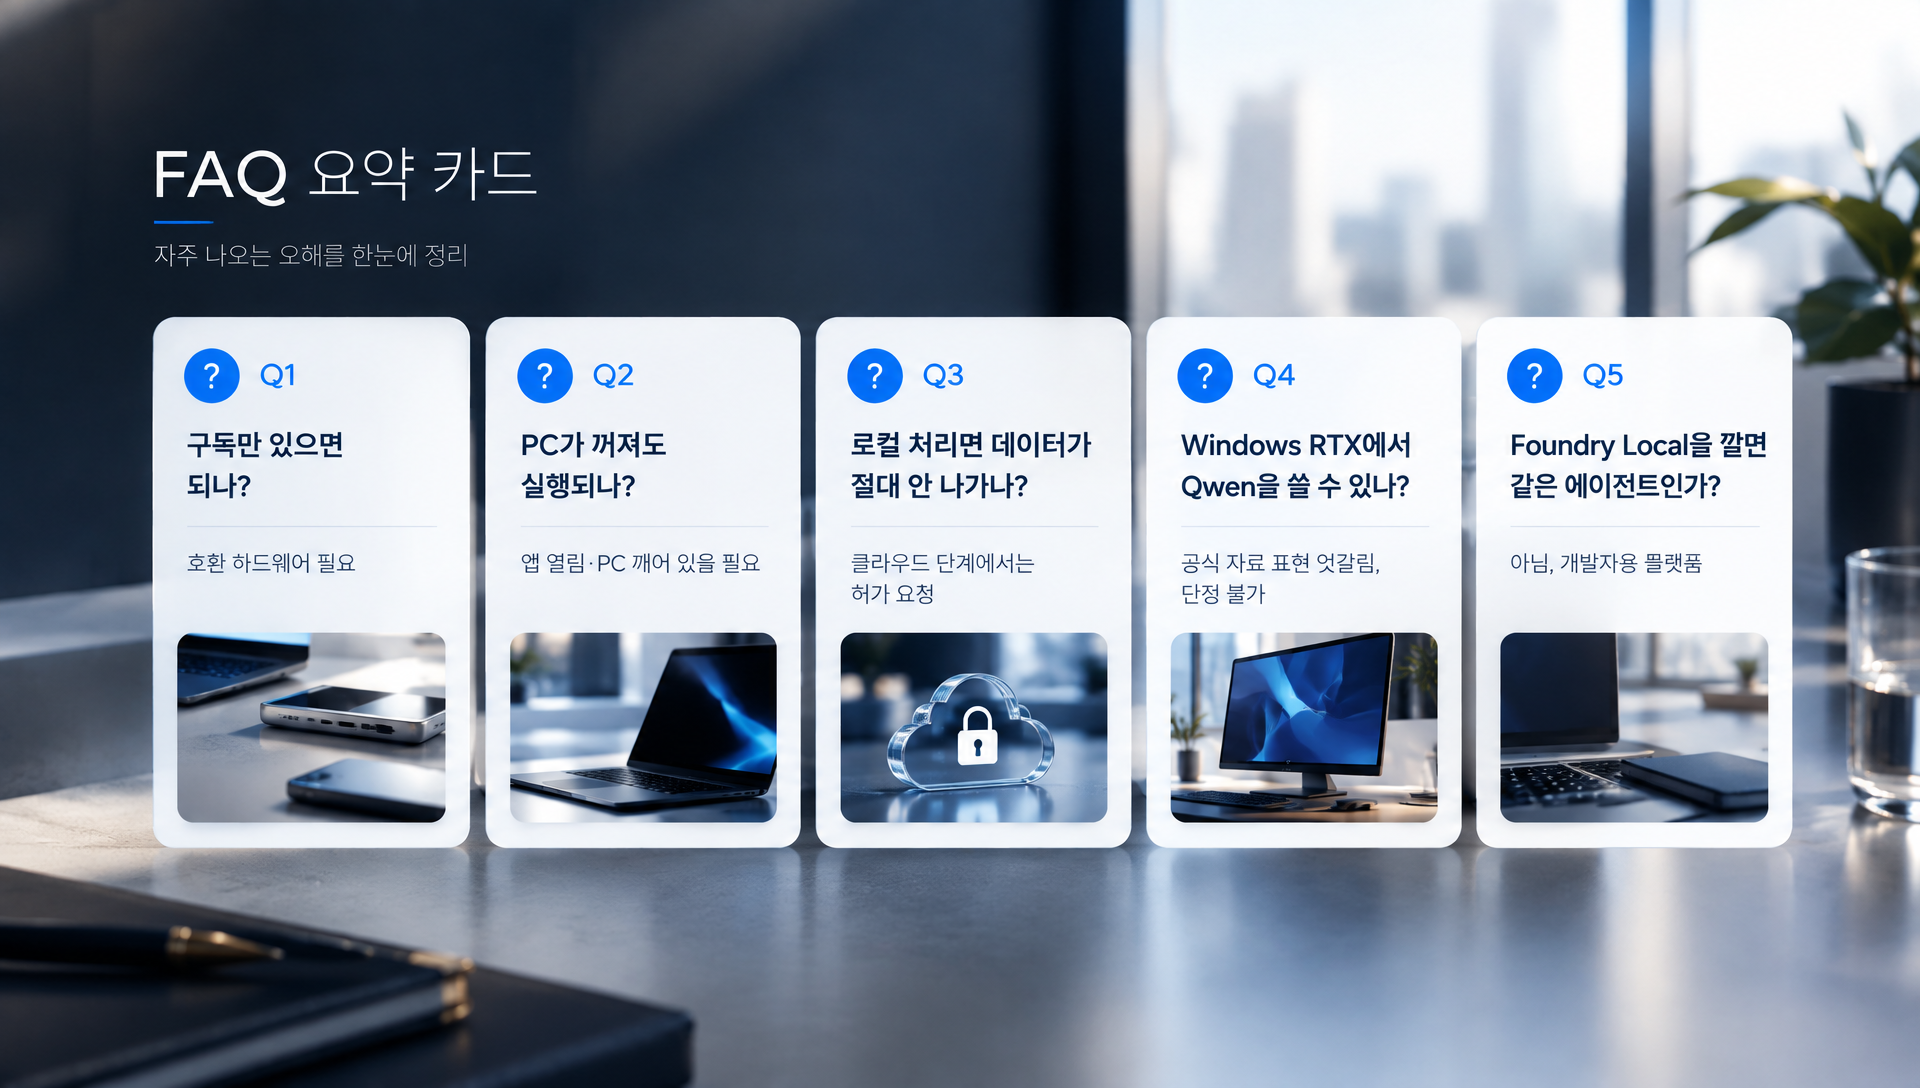
윈도우 로컬 AI 에이전트 자주 묻는 질문
핵심 오해를 풀어 주는 다섯 가지 질문을 정리했습니다.
Q1. Pro·Max 구독만 있으면 로컬 실행이 되나요?
아닙니다. Windows용 Perplexity 앱의 Pro·Max 개인 및 기업 구독자가 대상이지만, 호환 하드웨어가 있어야 합니다. RTX 경로는 VRAM 24GB 이상, AMD Ryzen AI Max 경로는 GPU 사용 가능 메모리 24GB 이상이 기준입니다.
Q2. PC가 꺼져 있어도 예약 작업이 돌아가나요?
확인된 근거가 없습니다. 예약 작업은 앱이 열려 있고 PC가 깨어 있을 때 실행된다고 안내돼 있습니다.
Q3. 로컬 모델을 쓰면 데이터가 절대 기기 밖으로 나가지 않나요?
그렇게 단정할 수 없습니다. 로컬 추론으로 끝나는 작업은 기기 안에서 처리되지만, 최신 웹 정보나 더 강한 추론이 필요하면 Perplexity Search나 클라우드 모델로 이어질 수 있습니다. 기기 밖으로 보내는 단계에서는 사용자 허가를 요청한다고 회사가 설명합니다.
Q4. Windows RTX PC에서 Qwen 모델을 쓸 수 있나요?
공식 자료 간 표현이 엇갈려 단정하기 어렵습니다. 제품 페이지에서 Qwen 3.8 27B가 제공되지 않는다고 한 부분은 Linux RTX PC에 관한 것이고, NVIDIA 발표문은 Qwen 3.8 27B를 RTX GPU 최적화 사례로 언급합니다. 설치 후 앱의 모델 목록을 확인하세요. AMD Ryzen AI Max 경로에는 PPLX 27B와 Qwen 27B가 안내돼 있습니다.
Q5. Foundry Local이나 Windows ML을 설치하면 같은 에이전트를 쓸 수 있나요?
아닙니다. 이들은 앱 개발자가 로컬 AI를 통합하거나 모델을 실행하기 위한 플랫폼 선택지입니다. 완성형 PC 에이전트나 모든 Windows PC의 자동화 권한을 뜻하지 않습니다.
참고 자료
- Perplexity, Portable Computer for Windows is here: https://www.perplexity.ai/en-GB/hub/blog/portable-computer-for-windows-is-here
- Perplexity, Portable Computer comes to AMD-powered agentic PCs: https://www.perplexity.ai/en-GB/hub/blog/portable-computer-comes-to-amd-powered-agentic-pcs
- NVIDIA Blog, 로컬 AI와 Perplexity Windows PC 관련 발표: https://blogs.nvidia.com/blog/local-ai-perplexity-windows-pcs/
- AMD Newsroom, Ryzen AI Max Series 및 Ryzen AI Halo 관련 발표: newsroom.amd.com
- Microsoft Learn, Microsoft Foundry on Windows(Windows AI APIs·Foundry Local·Windows ML) 문서: learn.microsoft.com
- 확인 기준일: 2026년 9월 27일. 이후 제품 페이지와 요건이 바뀔 수 있으므로 설치 전 공식 페이지를 다시 확인하세요.
📧 sales@vizensoft.com | 🌐 www.vizensoft.com | 📞 02-338-4610




 상담요청
-

-
CONTACT US
- 제작문의210번
- 안내0번
- 장애처리9번

사업자등록번호 : 108-81-65306 | 대표자 : 김지훈
주소 : (우)08510 서울특별시 금천구 벚꽃로 298, 대륭포스트타워 6차 1307호
COPYRIGHT 2004-2026 VIZENSOFT ALL RIGHTS RESERVED.
개인정보처리방침