

Deep Insight Into
IT Technology & Trends
통찰력 있는 사람들이 함께하는 젊고 열정적인 IT 기업, 비젠메디컬.
 Back
클로드 오퍼스 5.5 vs GPT-6 Sol, 단가와 성능 차이 비교
클로드 오퍼스 5.5 vs GPT-6 Sol, 단가와 성능 차이 비교 - 2026년 9월 22일, 앤트로픽의 클로드 오퍼스 5.5와 OpenAI의 GPT-6 Sol이 같은 날
 131
# 클로드 오퍼스 5.5 vs GPT-6 Sol, 단가와 성능 차이 비교
2026년 9월 22일 같은 날 출시된 두 모델, 개발자와 실무자는 무엇을 기준으로 골라야 할까
2026년 9월 22일, 앤트로픽의 클로드 오퍼스 5.5와 OpenAI의 GPT-6 Sol이 같은 날 공개됐다. 두 모델 모두 코딩과 복잡한 업무 처리를 겨냥한 상위급 모델이라는 공통점이 있고, 공교롭게 출시일까지 겹치면서 API를 사용해 서비스를 개발하거나 업무에 AI를 도입하려는 사람들 사이에서 자연스럽게 비교 대상이 됐다.
문제는 단순히 "1M토큰당 얼마"라는 표면적인 단가만 보고 결정하면 실제 업무에서는 다른 결과를 얻을 수 있다는 점이다. 오퍼스 5.5는 GPT-6 Sol보다 입력·출력 요금이 두 배지만, 같은 문제를 풀게 했을 때 실제로 청구되는 금액인 "과업당 비용"으로 보면 격차가 크게 줄어든다. 반대로 추론 강도를 높일수록 오퍼스 5.5의 비용은 가파르게 상승한다.
이 글은 API를 붙여 서비스를 만드는 개발자, 사내 업무 자동화를 검토하는 담당자, 문서 작성이나 코드 리뷰에 AI를 활용하는 실무자를 대상으로 한다. 단가표만 보고 판단하지 말고, 자신의 업무가 어떤 추론 설정에서 어떤 품질을 요구하는지 먼저 파악한 뒤 선택하라는 것이 이 글의 핵심 메시지다.
무엇을 기준으로 비교해야 하는가
이 비교에서 가장 중요한 기준은 "1M토큰당 단가"가 아니라 "같은 문제 하나를 끝까지 풀게 했을 때 실제로 나온 요금"이다. 단가가 절반이어도 답변에 토큰을 더 많이 쓰면 실제 청구액 차이는 줄어들 수 있고, 반대로 단가가 높아도 짧게 답하면 총비용이 낮아질 수 있기 때문이다.
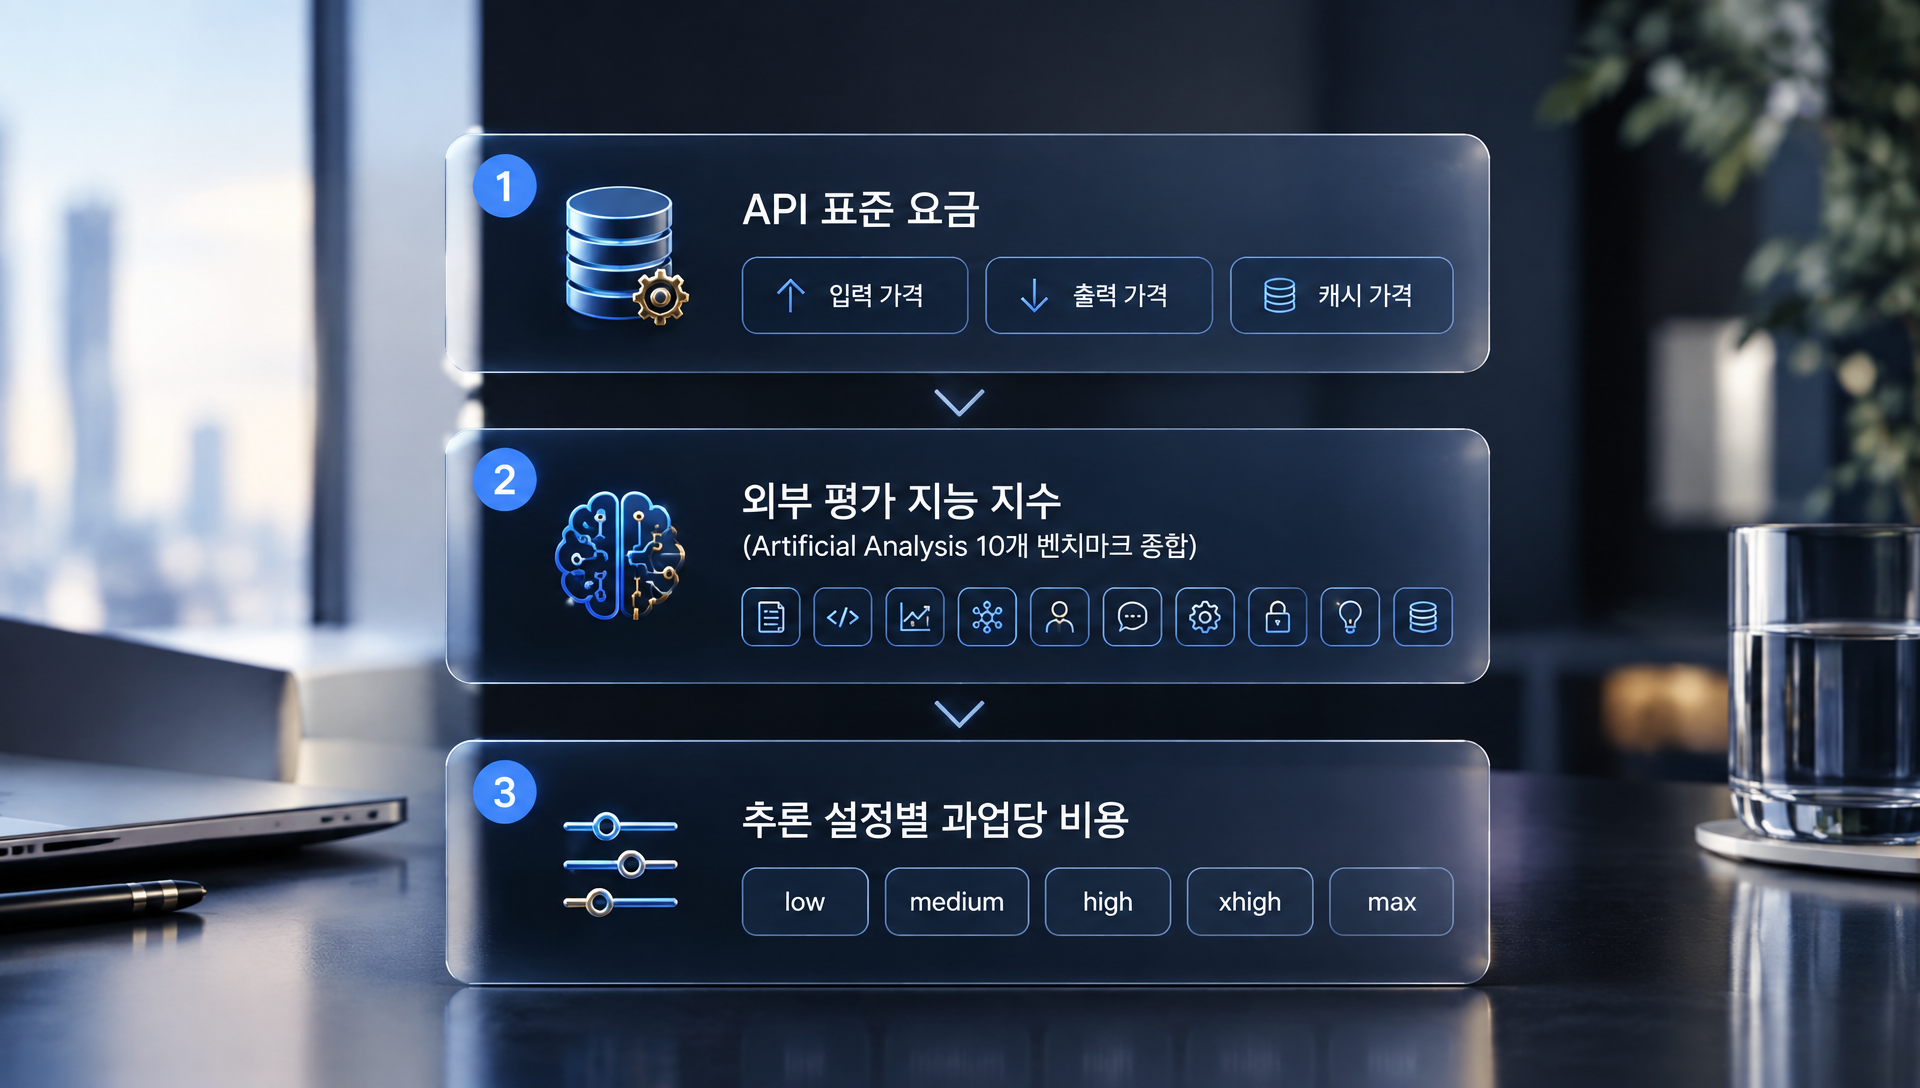
이 글에서는 세 가지 층위로 나눠 비교한다.
첫째, API 표준 요금이다. 1M토큰(AI가 글을 읽고 쓰는 단위 100만 개)당 입력·출력 가격을 그대로 비교하는 가장 기본적인 지표다.
둘째, 외부 평가 기관의 지능 지수다. Artificial Analysis라는 독립 평가 기관이 10개 벤치마크를 종합해 매긴 점수로, 두 회사가 각자 발표한 자체 벤치마크는 조건이 달라 나란히 비교할 수 없기 때문에 같은 조건에서 비교 가능한 자료는 사실상 이것뿐이다.
셋째, 추론 설정별 과업당 비용이다. 추론 설정(low~max)은 AI를 얼마나 오래 생각하게 할지 정하는 단계로, 높일수록 품질은 오르지만 그만큼 토큰 사용량과 비용도 늘어난다.
이 세 가지를 따로 보지 않고 겹쳐서 봐야 진짜 그림이 보인다. 단가만 보면 GPT-6 Sol이 유리해 보이지만, 설정별 표를 함께 보면 어떤 업무에 어떤 모델이 맞는지가 달라진다. 아래에서 각 모델의 특징을 먼저 살펴본 뒤, 종합 비교와 업무별 선택 기준을 순서대로 다룬다.
클로드 오퍼스 5.5, 높은 품질 상한과 그만큼 오르는 비용
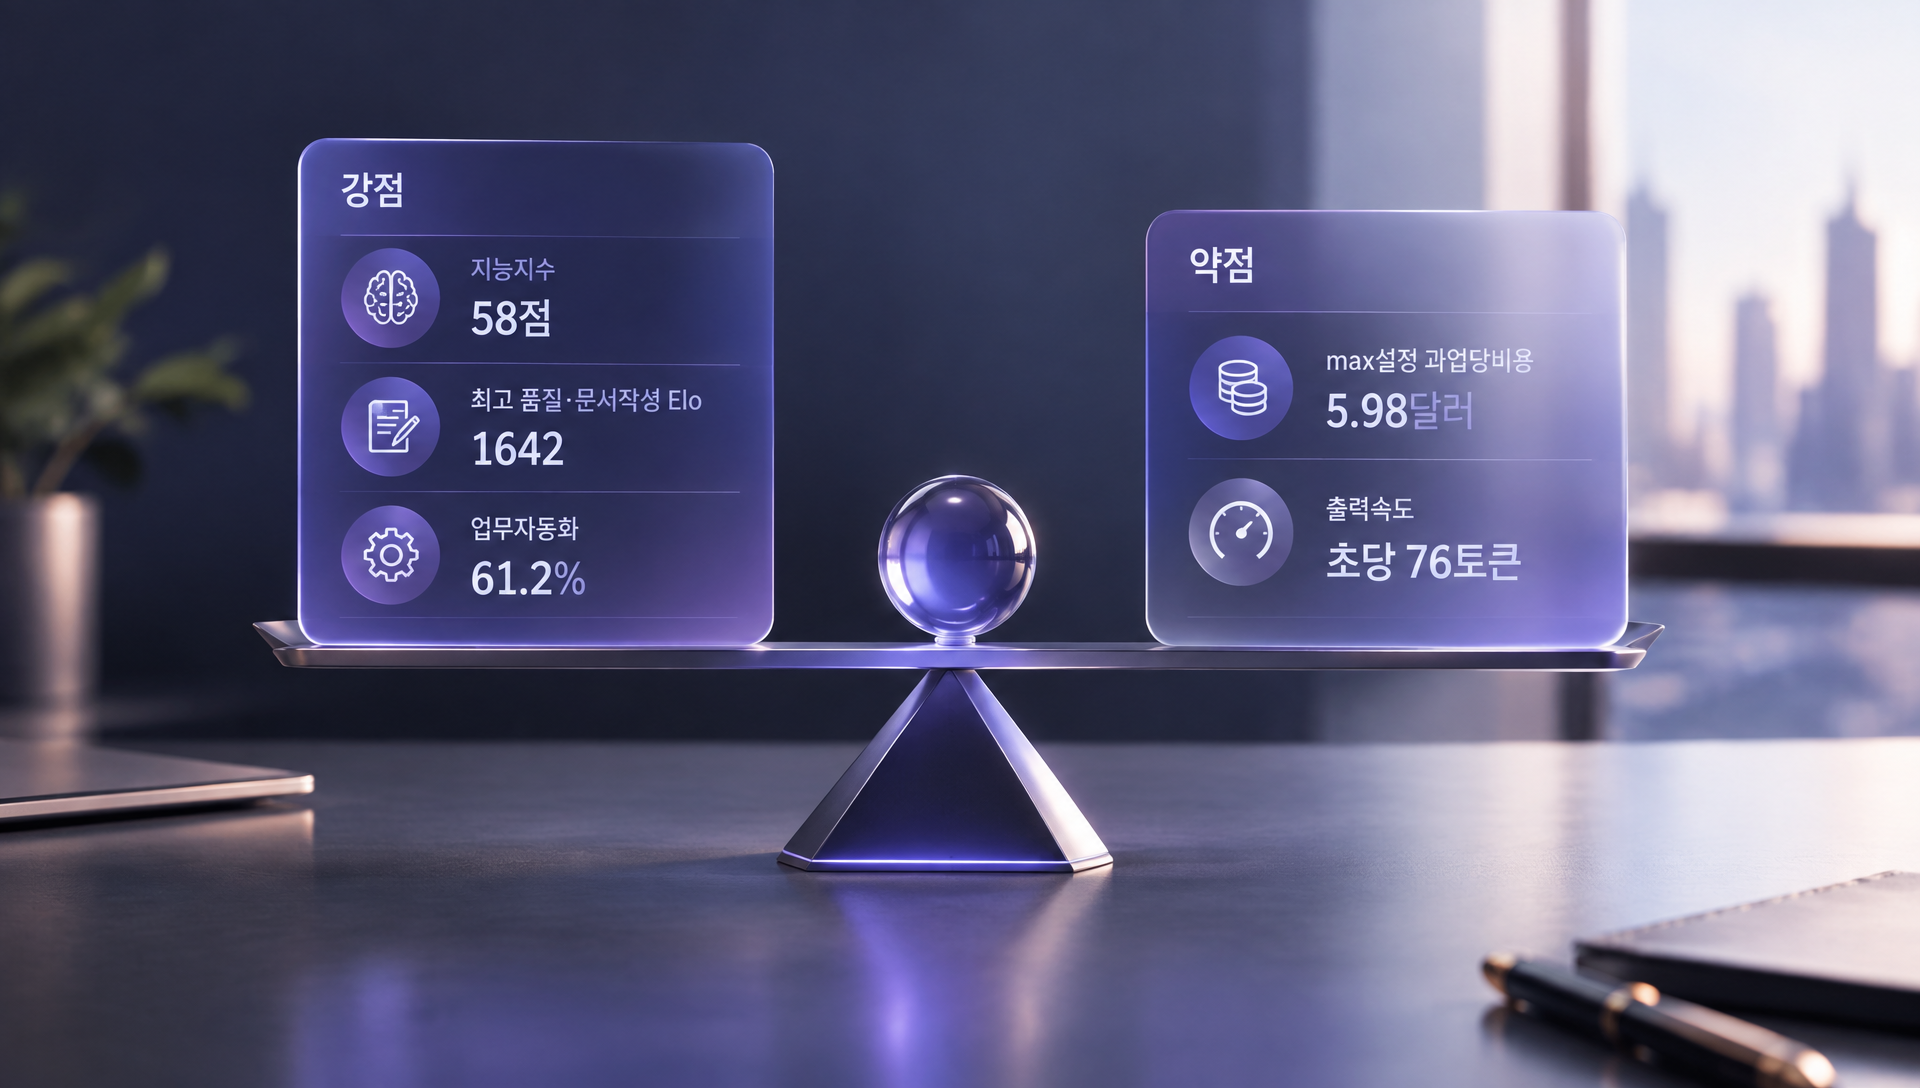
클로드 오퍼스 5.5는 최고 설정(max)에서 외부 평가 지능 지수 58점(정확히는 57.6점)을 기록해 두 모델 중 가장 높은 품질 상한을 보여준다. 앤트로픽은 이 모델이 코딩과 지식 업무에서 자사 상위 모델인 페이블 5.1 수준의 성능을 낸다고 공식적으로 밝혔다.
주목할 점은 오퍼스 5.5가 기본 설정(medium)만으로도 51.2점을 기록해, GPT-6 Sol의 최고 설정(max, 47.5점)보다 높다는 것이다. 즉 오퍼스 5.5는 추론 강도를 크게 높이지 않아도 상대 모델의 최상위 설정을 웃도는 결과를 낼 수 있다는 뜻이다.
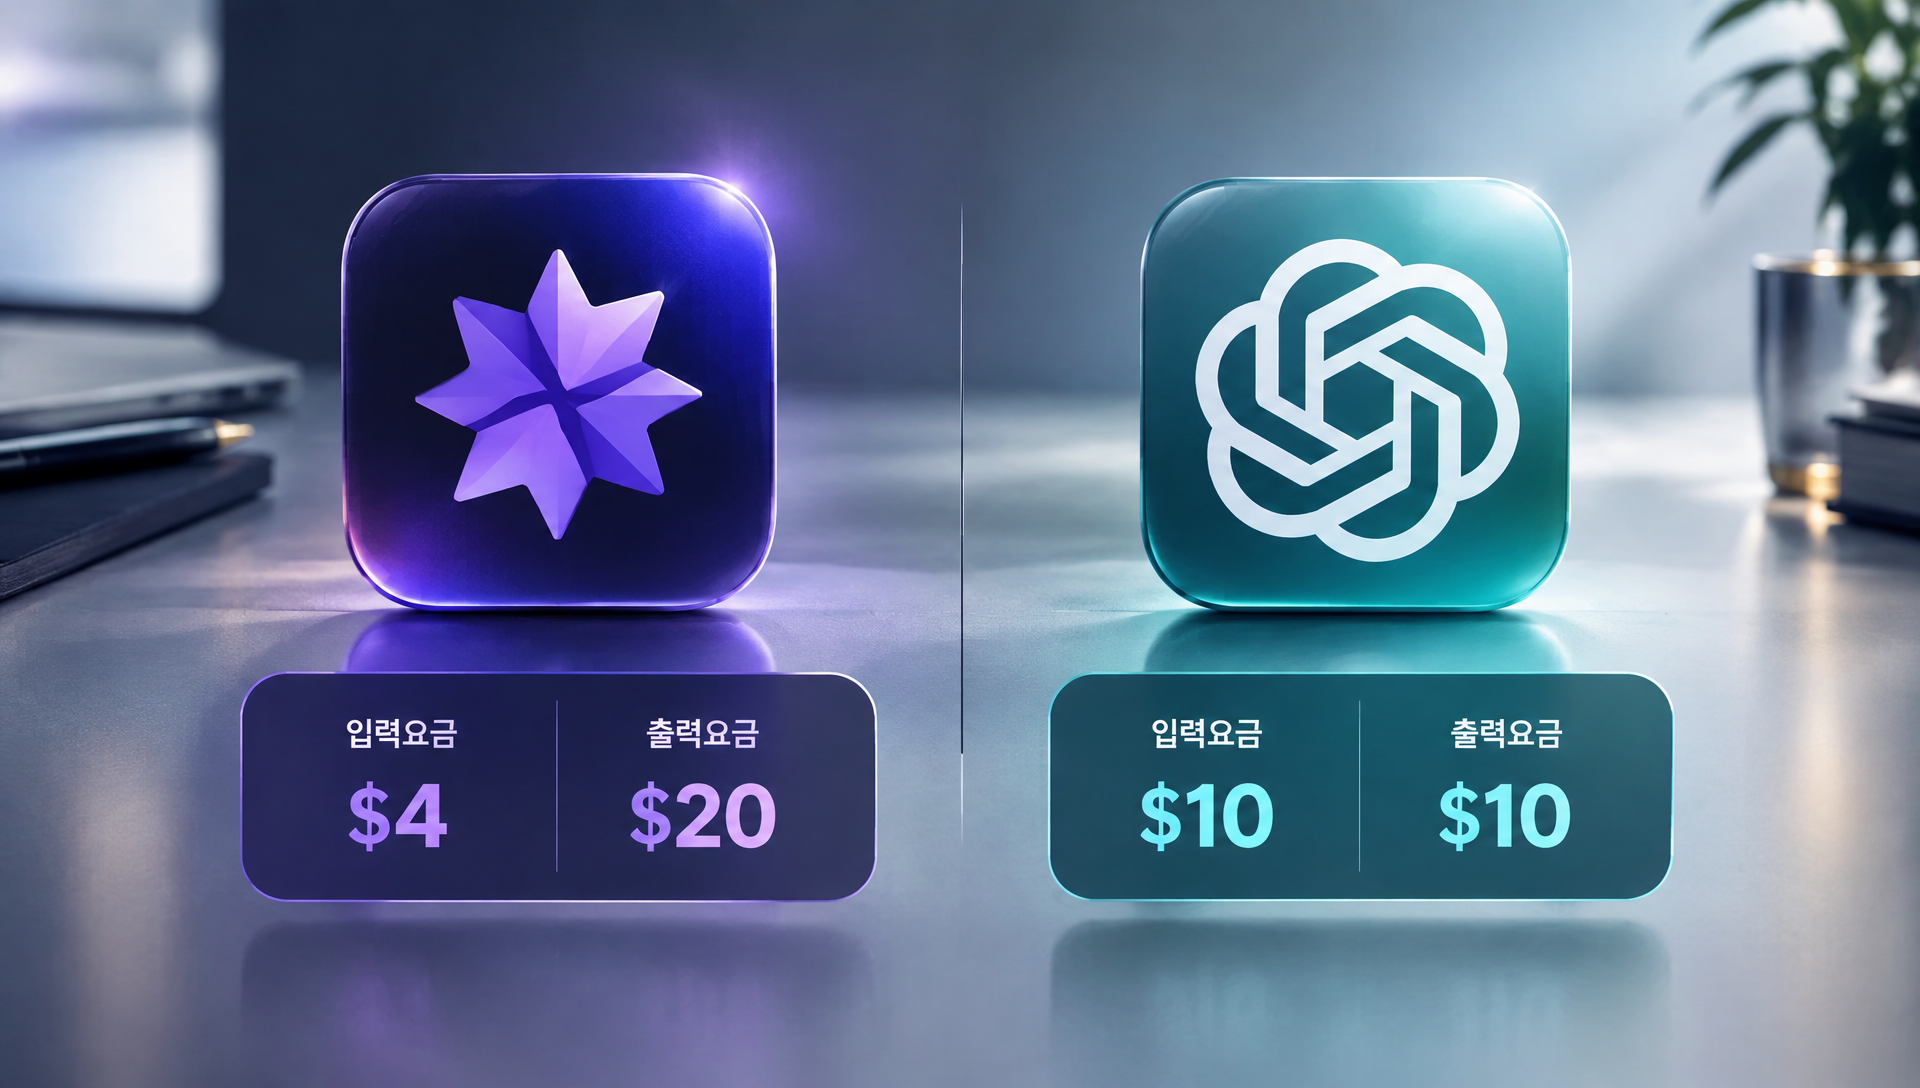
요금 구조를 보면 입력 1M토큰당 4달러, 출력 1M토큰당 20달러로 GPT-6 Sol의 정확히 두 배다. 다만 캐시 읽기 요금은 1M토큰당 0.20달러로 두 모델이 동일하며, 이는 입력가의 5%에 해당한다. 이 수치는 전작인 오퍼스 5(0.50달러)보다 60% 낮아진 것으로, 반복 사용되는 프롬프트나 긴 문서를 여러 차례 참조하는 작업에서는 비용 절감 폭이 상당하다.
컨텍스트 창(AI가 한 번에 참고할 수 있는 글의 최대 분량)은 약 100만 토큰, 일반 요청 기준 최대 출력은 128,000토큰으로 GPT-6 Sol과 동일한 수준이다.
세부 평가에서 오퍼스 5.5(medium)는 다음과 같은 강점을 보였다.
① 문서형 지식 업무를 측정하는 GDPval-AA에서 1576 Elo(여러 모델의 결과물을 맞대결시켜 매긴 상대 점수)를 기록해 GPT-6 Sol(max)의 1487 Elo보다 높았다.
② 업무 문서 작성 능력을 측정하는 AA-Briefcase에서는 1642 Elo로 GPT-6 Sol(max)의 1483 Elo와 격차가 더 컸다.
③ 업무 자동화 성능을 측정하는 AutomationBench-AA에서는 61.2%로 GPT-6 Sol(max)의 61.6%와 거의 비슷한 수준이었다.
약점은 명확하다. 추론 강도를 최고(max)로 올리면 과업당 출력 토큰이 약 11만 9천 개까지 늘어나며, 과업당 비용이 약 5.98달러까지 치솟는다. 출력 속도도 초당 약 76토큰(medium 기준)으로 GPT-6 Sol(max, 초당 약 126토큰)보다 느린 편이라, 실시간 응답이 중요한 서비스에는 부담이 될 수 있다.
GPT-6 Sol, 절반 단가와 빠른 응답이 강점
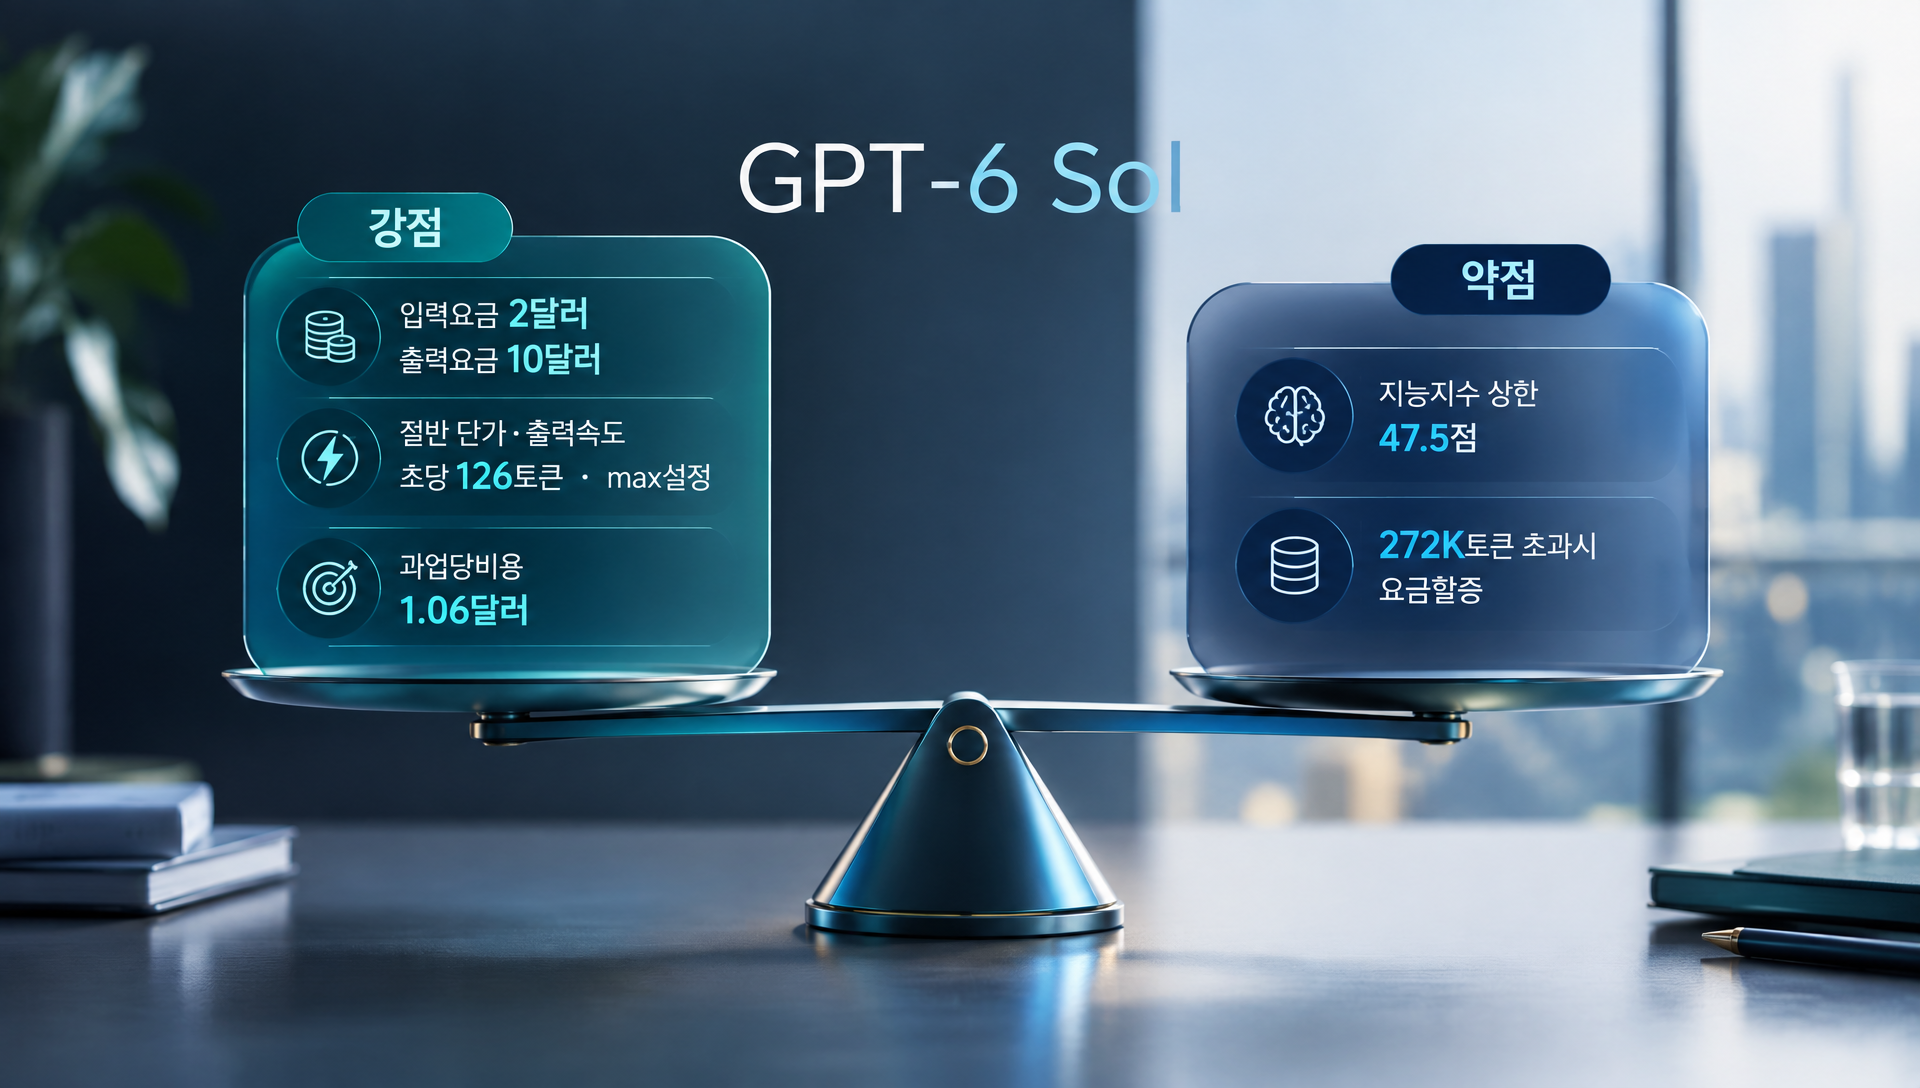
GPT-6 Sol의 가장 큰 강점은 API 표준 요금이 오퍼스 5.5의 정확히 절반이라는 점이다. 입력 1M토큰당 2달러, 출력 1M토큰당 10달러로 책정됐고, 캐시 읽기는 오퍼스 5.5와 동일하게 1M토큰당 0.20달러(입력가의 10%)다. OpenAI는 이 모델을 복잡한 코딩과 에이전트 업무용으로 공식 소개했다.
컨텍스트 창은 1,050,000토큰으로 오퍼스 5.5(약 100만 토큰)와 비슷한 수준이고, 일반 요청 기준 최대 출력도 128,000토큰으로 동일하다. 다만 입력이 272K토큰을 넘어가면 요청 전체에 입력 2배·출력 1.5배의 요금이 붙는 구조가 있다는 점은 주의할 부분이다. 대용량 문서나 긴 코드베이스 전체를 한 번에 입력하는 작업에서는 이 기준선을 넘는지 미리 계산해봐야 실제 비용을 예측할 수 있다.
출력 속도는 최고 설정(max) 기준 초당 약 126토큰으로, 오퍼스 5.5(medium 기준 초당 약 76토큰)보다 눈에 띄게 빠르다. 응답 속도가 사용자 경험에 직접 영향을 주는 챗봇이나 실시간 코드 자동완성 같은 서비스에서는 이 차이가 체감될 수 있다.
지능 지수 측면에서는 최고 설정(max)에서 47.5점, 기본 설정(medium)에서 약 39.8점을 기록해 오퍼스 5.5보다 전반적으로 낮은 점수대에 위치한다. 다만 업무 자동화 성능(AutomationBench-AA)에서는 61.6%로 오퍼스 5.5(medium, 61.2%)와 거의 차이가 없거나 오히려 근소하게 앞섰다. 이는 모든 영역에서 일방적으로 밀리는 것이 아니라 특정 업무 유형에서는 대등한 성능을 낸다는 의미로 해석할 수 있다.
설정별 표를 보면 GPT-6 Sol의 진짜 강점이 드러난다. low 설정에서는 과업당 비용이 0.13달러에 불과하고, medium 설정에서도 0.25달러 수준이다. 추론 강도를 최고로 올려도(max) 과업당 비용은 1.06달러로, 오퍼스 5.5의 medium 설정(1.34달러)보다 오히려 낮다. 즉 적은 비용으로 준수한 품질을 뽑아내는 데 최적화된 구조라고 볼 수 있다.
약점은 지능 지수의 절대적인 상한이다. 아무리 추론 강도를 max로 올려도 47.5점이 한계이며, 이는 오퍼스 5.5의 기본 설정(medium, 51.2점)에도 못 미치는 수준이다. 품질의 최고치가 필요한 업무라면 이 상한선이 제약이 될 수 있다.
설정별로 뒤바뀌는 이야기, 단가 절반이 곧 비용 절반은 아니다
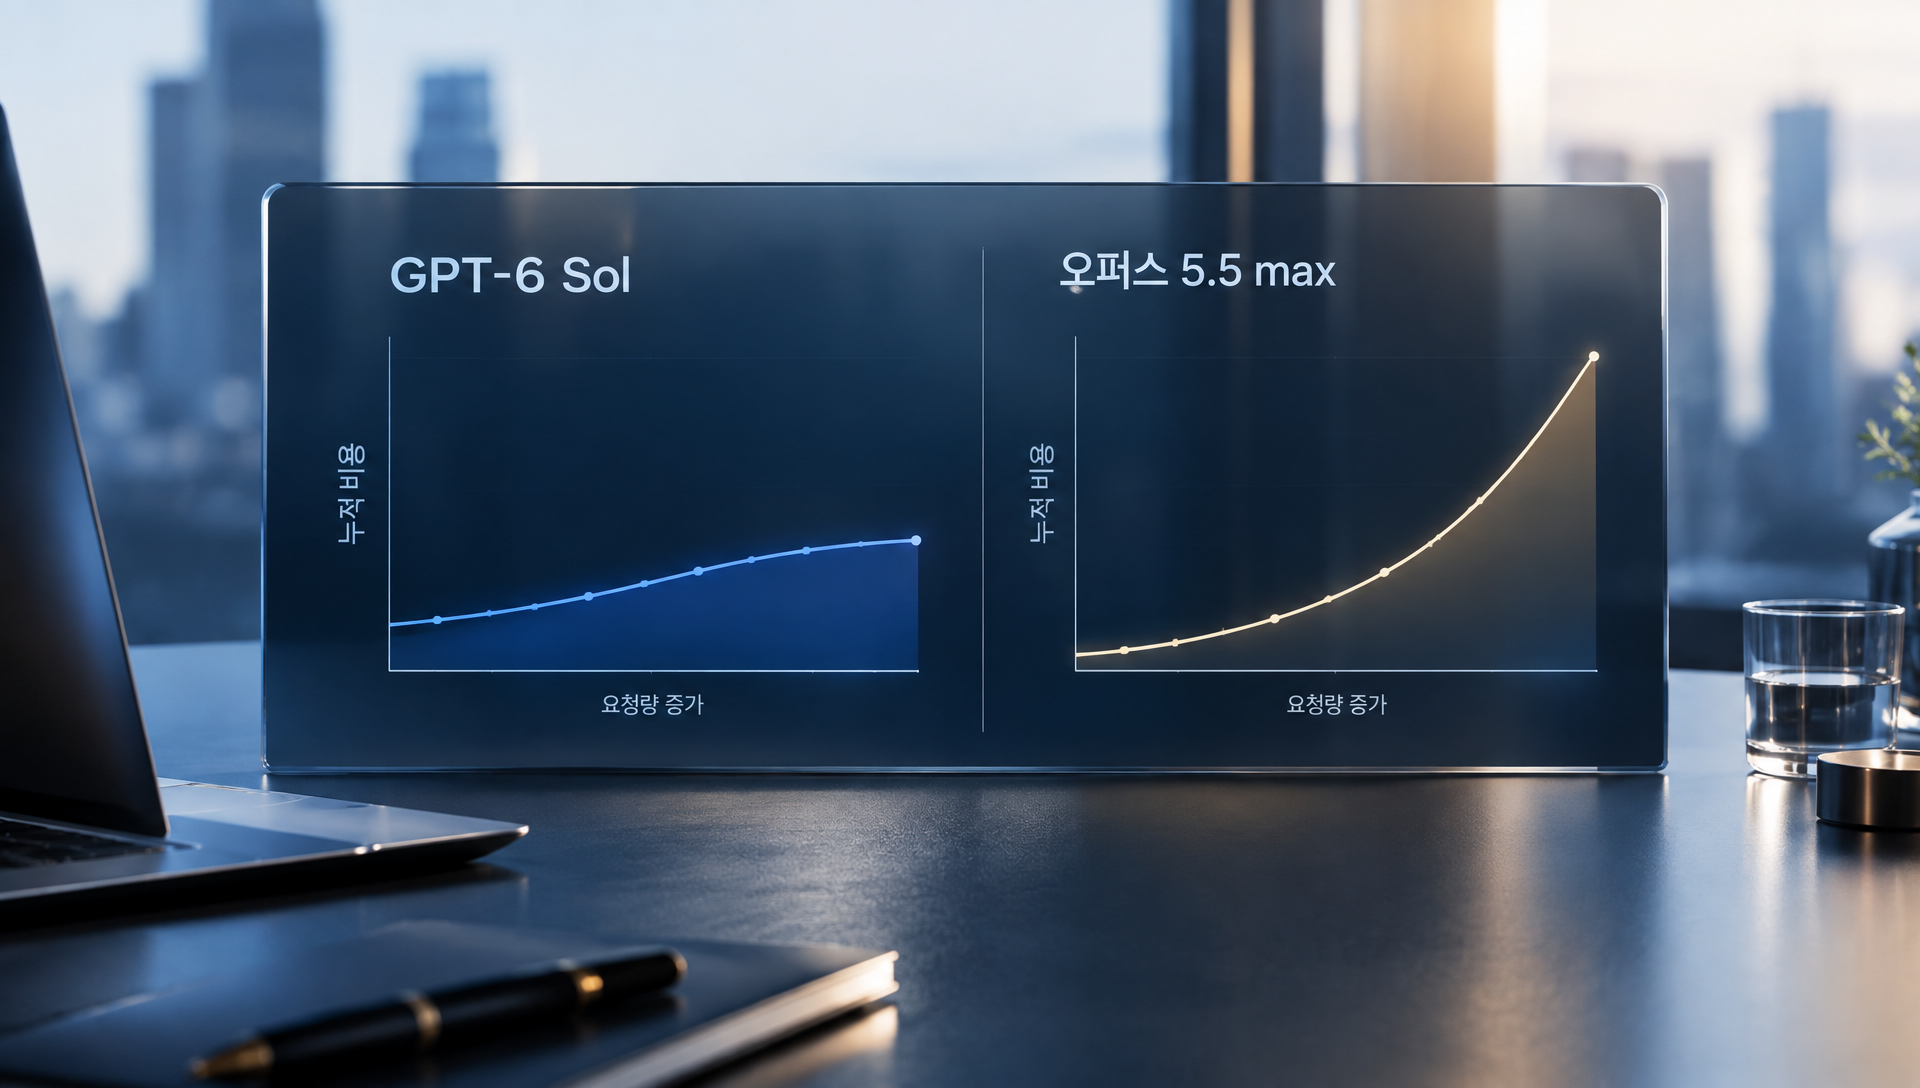
단가만 보면 GPT-6 Sol이 오퍼스 5.5의 절반이지만, 실제 과업당 비용으로 환산하면 이 격차는 크게 줄어들거나 상황에 따라 역전되기도 한다. Artificial Analysis가 정리한 자료에 따르면 같은 지능 지수를 만드는 데 든 비용은 오퍼스 5.5(medium) 1.34달러, GPT-6 Sol(max) 1.06달러로, 단가 차이(2배)보다 실제 비용 차이(약 1.3배)가 훨씬 작다.
이 현상이 발생하는 이유는 간단하다. 오퍼스 5.5는 같은 질문에 대해 상대적으로 적은 토큰으로 답을 완성하는 경향이 있어, 단가가 높아도 총사용량이 적어 격차가 줄어드는 것이다. 반대로 오퍼스 5.5를 최고 설정(max)으로 돌리면 과업당 출력 토큰이 약 11만 9천 개까지 늘어나면서 과업당 비용이 약 5.98달러까지 급등한다.
Artificial Analysis 수치를 정리한 자료를 기준으로 설정 단계별 지능 지수와 과업당 비용을 나란히 놓으면 다음과 같다.
| 추론 설정 | 오퍼스 5.5 (지능지수·비용) | GPT-6 Sol (지능지수·비용) |
|---|---|---|
| low | 42.3점 · 0.55달러 | 33.9점 · 0.13달러 |
| medium | 51.2점 · 1.34달러 | 39.8점 · 0.25달러 |
| high | 53.6점 · 1.82달러 | 42.8점 · 0.37달러 |
| xhigh | 56.0점 · 3.46달러 | 44.1점 · 0.53달러 |
| max | 57.6점 · 5.98달러 | 47.5점 · 1.06달러 |
이 표에서 읽을 수 있는 핵심은 두 가지다.
첫째, 적은 비용으로 적당한 품질이면 GPT-6 Sol의 low~medium 설정이 압도적으로 저렴하다. 0.13달러에서 0.25달러 수준이면 오퍼스 5.5의 어떤 설정보다도 낮은 비용으로 작업을 처리할 수 있다.
둘째, 높은 품질 상한이 필요하다면 오퍼스 5.5 쪽으로 무게가 실린다. GPT-6 Sol은 아무리 설정을 올려도 47.5점이 한계지만, 오퍼스 5.5는 medium 설정(51.2점)만으로 이미 그 상한을 넘어서고, max 설정(57.6점)까지 올리면 격차가 더 벌어진다.
즉 "품질을 어디까지 요구하느냐"가 비용 구조를 완전히 뒤바꾼다. 저비용·적당한 품질이 목표라면 GPT-6 Sol의 낮은 설정이 유리하고, 품질 최상한이 필요하다면 비용을 감수하고 오퍼스 5.5를 max에 가깝게 쓰는 편이 합리적일 수 있다.
종합 비교, 한 모델이 모든 지표에서 앞서지 않는다
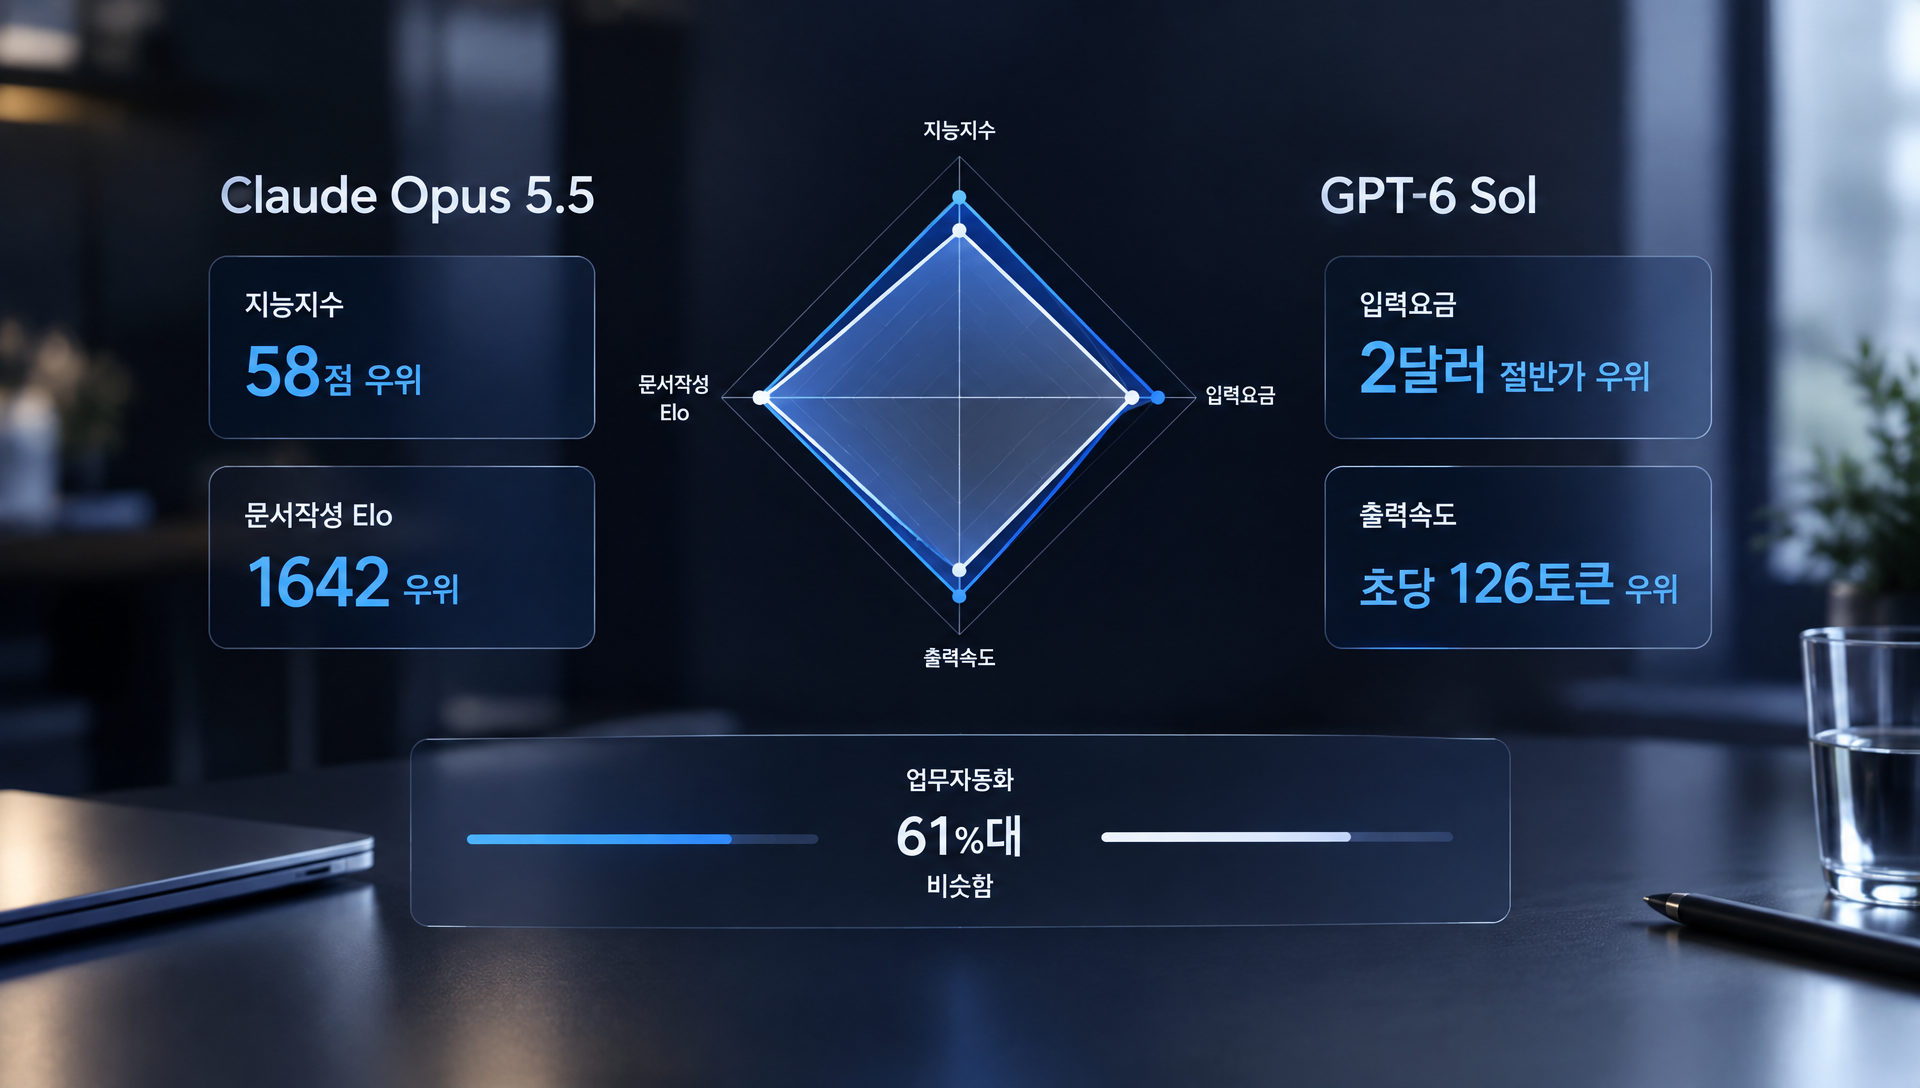
두 모델을 나란히 놓고 보면 어느 쪽도 모든 지표에서 우위를 점하지 않는다는 것이 가장 분명한 결론이다. 단가, 지능 지수, 과업당 비용, 출력 속도라는 네 가지 축에서 각 모델이 우위를 보이는 영역이 서로 다르게 나뉜다.
단가 측면에서는 GPT-6 Sol이 명확히 유리하다. 입력·출력 요금 모두 오퍼스 5.5의 절반이며, 캐시 읽기 요금만 동일하다.
지능 지수 측면에서는 오퍼스 5.5가 전 구간에서 앞선다. 같은 추론 설정 단계를 비교하면 low부터 max까지 모든 구간에서 오퍼스 5.5의 점수가 GPT-6 Sol보다 높게 나타난다.
과업당 비용은 어떤 설정을 쓰느냐에 따라 순위가 갈린다. 낮은 설정 구간에서는 GPT-6 Sol이 훨씬 저렴하지만, 오퍼스 5.5의 medium 설정과 GPT-6 Sol의 max 설정을 비교하면 격차가 약 1.3배로 좁혀진다.
출력 속도는 GPT-6 Sol이 초당 약 126토큰(max)으로 오퍼스 5.5의 초당 약 76토큰(medium)보다 빠르다. 응답 지연이 민감한 서비스에는 이 차이가 실질적인 영향을 미친다.
세부 업무 성능에서도 일방적이지 않다. 문서형 지식 업무와 업무 문서 작성에서는 오퍼스 5.5(medium)가 GPT-6 Sol(max)보다 뚜렷하게 앞섰지만, 업무 자동화 성능은 두 모델이 61%대로 거의 대등했다.
여기서 반드시 짚어야 할 한계가 있다. 이 비교의 근거인 Artificial Analysis 지수는 외부 평가 기관 한 곳이 출시 직후 측정한 값이며, 두 회사가 각자 발표한 벤치마크(예: 앤트로픽의 Terminal-Bench, OpenAI의 DeepSWE)는 평가 조건이 달라 이 글에서 다루지 않았다. 같은 조건에서 비교 가능한 공개 자료가 현재로서는 이 외부 평가 지수뿐이라는 점, 그리고 각 회사가 공개하는 고객 사례 역시 회사가 선별한 사례라는 점도 판단에 참고해야 한다.
대량 처리와 빠른 응답이 중요하다면
대량의 요청을 처리하거나 응답 속도가 사용자 경험에 직결되는 경우, 예산 효율까지 고려한다면 GPT-6 Sol의 낮은 설정 구간이 합리적인 선택이 된다. 이는 특정 업무 유형에서 GPT-6 Sol이 갖는 구조적 이점 때문이다.
예를 들어 대량의 고객 문의를 자동 분류하거나, 짧은 코드 스니펫을 반복적으로 생성하는 작업, 실시간 챗봇처럼 응답 지연이 즉각적인 불만으로 이어지는 서비스를 떠올려보면 이해하기 쉽다. 이런 업무는 한 건 한 건의 품질 상한보다 일관된 응답 속도와 낮은 단위 비용이 더 중요한 경우가 많다.
설정별 표에서 확인했듯 GPT-6 Sol은 low 설정에서 과업당 0.13달러, medium 설정에서도 0.25달러 수준으로 처리할 수 있다. 하루에 수천, 수만 건의 요청을 처리해야 하는 서비스라면 이 단위 비용 차이가 누적되어 전체 운영 비용에 큰 영향을 준다. 출력 속도 역시 초당 약 126토큰(max 기준)으로 오퍼스 5.5보다 빨라, 사용자가 답변을 기다리는 체감 시간을 줄이는 데도 유리하다.
다만 이 선택이 항상 맞는 것은 아니다. 272K토큰을 넘는 대용량 입력을 자주 다뤄야 하는 경우라면 GPT-6 Sol의 요금 할증 구조(입력 2배·출력 1.5배)를 미리 계산해봐야 한다. 긴 문서를 통째로 넣고 요약하거나 분석하는 업무가 잦다면, 예상보다 비용이 커질 수 있으므로 실제 입력 길이 분포를 먼저 확인하는 것이 좋다.
완성도 높은 결과물이 필요하다면
보고서나 업무 문서처럼 결과물의 완성도 자체가 평가받는 업무라면 오퍼스 5.5가 더 나은 결과를 낼 가능성이 높다. 세부 평가 수치가 이 판단을 뒷받침한다.
Artificial Analysis 수치를 정리한 자료에 따르면 업무 문서 작성 능력을 측정하는 AA-Briefcase에서 오퍼스 5.5(medium)는 1642 Elo를 기록해 GPT-6 Sol(max)의 1483 Elo보다 상당한 격차로 앞섰다. 문서형 지식 업무를 측정하는 GDPval-AA에서도 1576 Elo 대 1487 Elo로 오퍼스 5.5가 우위를 보였다.
이런 결과는 클라이언트에게 제출할 제안서, 내부 의사결정을 위한 분석 보고서, 법률·재무 검토 문서처럼 한 건의 결과물이 이후 여러 사람의 판단에 영향을 주는 업무에서 특히 의미가 있다. 이런 업무는 처리 건수가 많지 않은 대신, 한 건의 품질이 낮으면 재작업이나 수정에 드는 시간이 오히려 비용을 키운다.
오퍼스 5.5의 medium 설정만으로도 GPT-6 Sol의 max 설정보다 지능 지수가 높다는 점(51.2점 대 47.5점)을 고려하면, 굳이 오퍼스 5.5를 최고 설정으로 쓰지 않아도 상당한 품질을 확보할 수 있다는 것도 실무적으로 중요한 정보다. medium 설정 기준 과업당 1.34달러라는 비용은, 결과물의 완성도가 후속 업무 전체에 영향을 주는 상황에서는 충분히 감당할 만한 수준으로 볼 수 있다.
반면 업무 자동화처럼 반복적인 작업 흐름을 처리하는 영역에서는 두 모델의 차이가 거의 없었다는 점(61.2% 대 61.6%)도 함께 고려할 필요가 있다. 모든 업무에 오퍼스 5.5가 유리한 것은 아니라는 뜻이다.
도입 비용과 실제 운영 부담 비교
초기 도입 비용 자체는 두 모델 모두 API 요금제이므로 별도의 라이선스 계약 없이 사용량 기반으로 시작할 수 있다는 점에서 동일한 조건이다. 진짜 차이는 초기 비용이 아니라 사용량이 누적됐을 때의 운영 비용 구조에서 나타난다.
소규모 테스트 단계에서는 두 모델 모두 부담이 크지 않다. 예를 들어 하루 100건 정도의 요청을 처리하는 초기 검증 단계라면, GPT-6 Sol의 low~medium 설정은 과업당 0.13~0.25달러 수준이라 월 단위로도 큰 금액이 되지 않는다. 오퍼스 5.5도 medium 설정 기준 과업당 1.34달러이므로, 하루 100건이라면 월 400달러 안팎으로 예측 가능한 범위다.
문제는 요청량이 늘어나거나, 품질 상한이 필요해 오퍼스 5.5를 max 설정으로 올려야 하는 경우다. 이때는 과업당 5.98달러까지 오르므로, 하루 처리량이 수백 건 단위로 늘어나면 월간 비용 차이가 상당히 벌어질 수 있다. 반대로 GPT-6 Sol은 max 설정을 쓰더라도 과업당 1.06달러로 비교적 완만하게 오른다.
ROI(투자 대비 효과) 관점에서 볼 때 중요한 것은 단순 비용이 아니라 "그 비용으로 얻은 결과물을 다시 손볼 필요가 있는가"다. 완성도가 낮은 결과물을 받아 사람이 재작업하는 시간까지 포함하면, 표면적인 API 비용이 낮아도 총소요 시간과 비용은 더 커질 수 있다. 이 부분은 수치로 단정하기 어려운 영역이므로, 실제 업무 샘플로 직접 검증해보는 것이 가장 정확하다.
도입 기간 측면에서는 두 모델 모두 API 연동 자체는 기존 시스템에 엔드포인트만 교체하는 수준으로 빠르게 적용할 수 있어, 이 부분에서는 유의미한 차이가 나타나지 않는다.
결국 정답은 업무 샘플로 직접 확인하는 것
두 모델 중 어느 것이 절대적으로 낫다고 말할 수 없다는 것이 이 비교의 결론이다. 단가는 GPT-6 Sol이 절반이지만, 품질 상한은 오퍼스 5.5가 높고, 과업당 비용은 설정에 따라 순위가 뒤바뀐다.
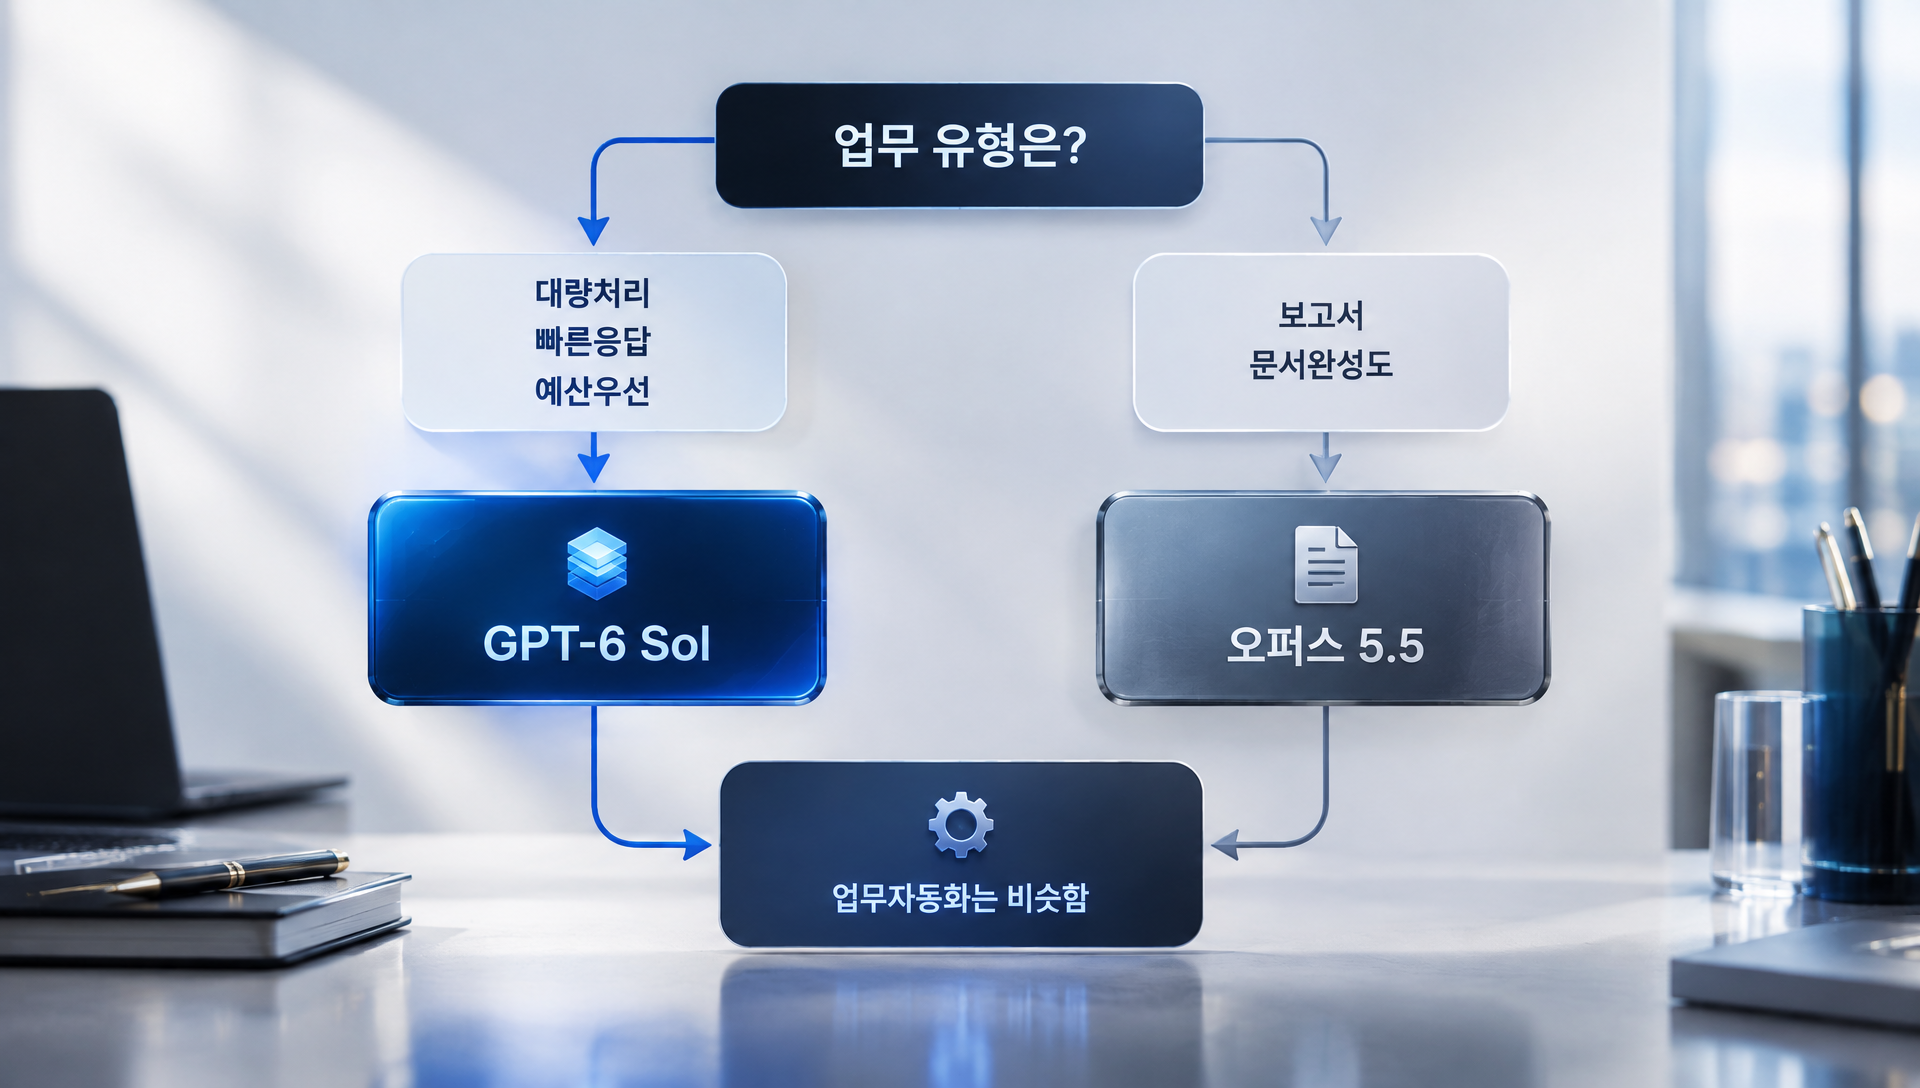
대량 처리·빠른 응답·예산 효율이 우선이라면 GPT-6 Sol의 low~medium 설정을 검토해볼 만하다. 보고서나 업무 문서처럼 결과물의 완성도가 중요한 작업이라면 오퍼스 5.5 쪽이 더 안정적인 결과를 줄 가능성이 있다. 업무 자동화처럼 두 모델이 비슷한 성능을 보이는 영역이라면 단가 차이가 더 결정적인 기준이 될 수 있다.
가장 확실한 방법은 실제로 처리할 업무 샘플 몇 건을 두 모델에 동일하게 입력해 결과물과 청구 비용을 직접 비교해보는 것이다. 외부 평가 지수는 참고 자료일 뿐, 각자의 업무 특성에 맞는 결론은 직접 테스트를 통해서만 얻을 수 있다.
자주 묻는 질문
Q1. 단가만 보면 GPT-6 Sol이 무조건 저렴한 것 아닌가?
표준 단가는 절반이 맞지만, 과업당 실제 비용은 설정에 따라 달라진다. 오퍼스 5.5(medium) 1.34달러, GPT-6 Sol(max) 1.06달러로 격차가 약 1.3배로 줄어드는 사례가 확인됐으므로, 단가표만으로 판단하지 말고 설정별 과업당 비용을 함께 확인하는 것이 정확하다.
Q2. 컨텍스트 창(입력 가능 분량)은 어느 쪽이 더 넉넉한가?
두 모델 모두 약 100만 토큰 수준으로 비슷하다. 다만 GPT-6 Sol은 입력이 272K토큰을 넘으면 요금 할증(입력 2배·출력 1.5배)이 적용되므로, 긴 문서를 자주 다룬다면 이 기준선을 미리 확인해야 한다.
Q3. 외부 평가 지능 지수를 그대로 믿어도 되는가?
Artificial Analysis라는 외부 평가 기관이 출시 직후 측정한 값이며, 같은 조건에서 비교 가능한 공개 자료로는 현재 이것이 유일하다. 다만 이는 특정 시점의 측정치이므로 업무 특성이나 이후 모델 업데이트에 따라 결과가 달라질 수 있다는 점을 감안해야 한다.
Q4. 두 회사가 발표한 자체 벤치마크(예: Terminal-Bench, DeepSWE)는 참고해도 되는가?
각 회사가 자체적으로 설정한 조건에서 측정한 값이라 평가 방식이 서로 달라 직접 비교하기 어렵다. 모델 자체의 성능 소개 자료로는 참고할 수 있지만, 두 모델을 나란히 놓고 우열을 가리는 근거로 쓰기에는 적절하지 않다.
Q5. 실제 도입 전에 무엇부터 해보는 것이 좋은가?
자신의 업무를 대표할 만한 샘플 요청 몇 건을 정한 뒤, 두 모델에 동일한 조건으로 입력해 결과물의 품질과 실제 청구 비용을 함께 기록해보는 것이 가장 실질적인 검증 방법이다.
참고 자료
- Anthropic, "Claude Opus 5.5" 공식 발표 (anthropic.com)
- Anthropic, "What a task costs on Opus 5.5" (claude.com/blog)
- Anthropic API 가격 정책 (platform.claude.com/docs)
- OpenAI, "Introducing GPT-6 Sol and Luna" (openai.com)
- OpenAI 개발자 문서 (developers.openai.com)
- Artificial Analysis, Claude Opus 5.5 분석 아티클 (artificialanalysis.ai)
- Artificial Analysis, GPT-6 Sol 모델 페이지 (artificialanalysis.ai)
- VentureBeat, 관련 보도 (venturebeat.com)
- TechCrunch, 관련 보도 (techcrunch.com)
- digitalapplied.com, Artificial Analysis 수치 정리 자료
📧 sales@vizensoft.com | 🌐 www.vizensoft.com | 📞 02-338-4610




 상담요청
-

-
CONTACT US
- 제작문의210번
- 안내0번
- 장애처리9번

사업자등록번호 : 108-81-65306 | 대표자 : 김지훈
주소 : (우)08510 서울특별시 금천구 벚꽃로 298, 대륭포스트타워 6차 1307호
COPYRIGHT 2004-2026 VIZENSOFT ALL RIGHTS RESERVED.
개인정보처리방침